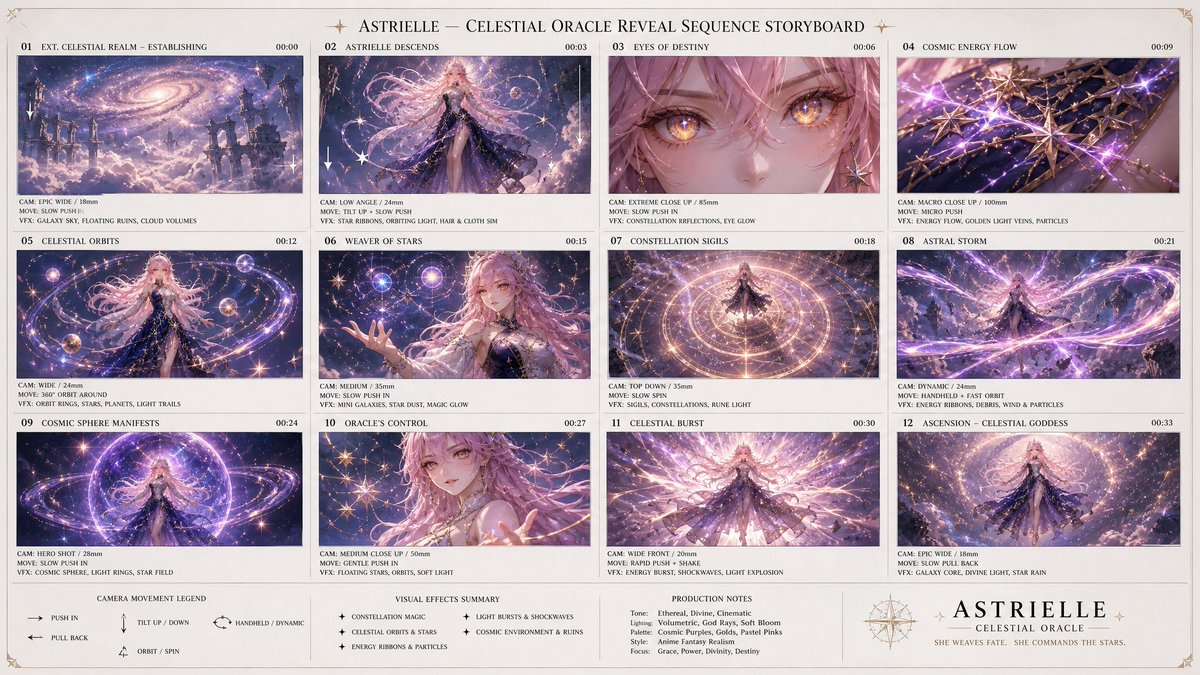
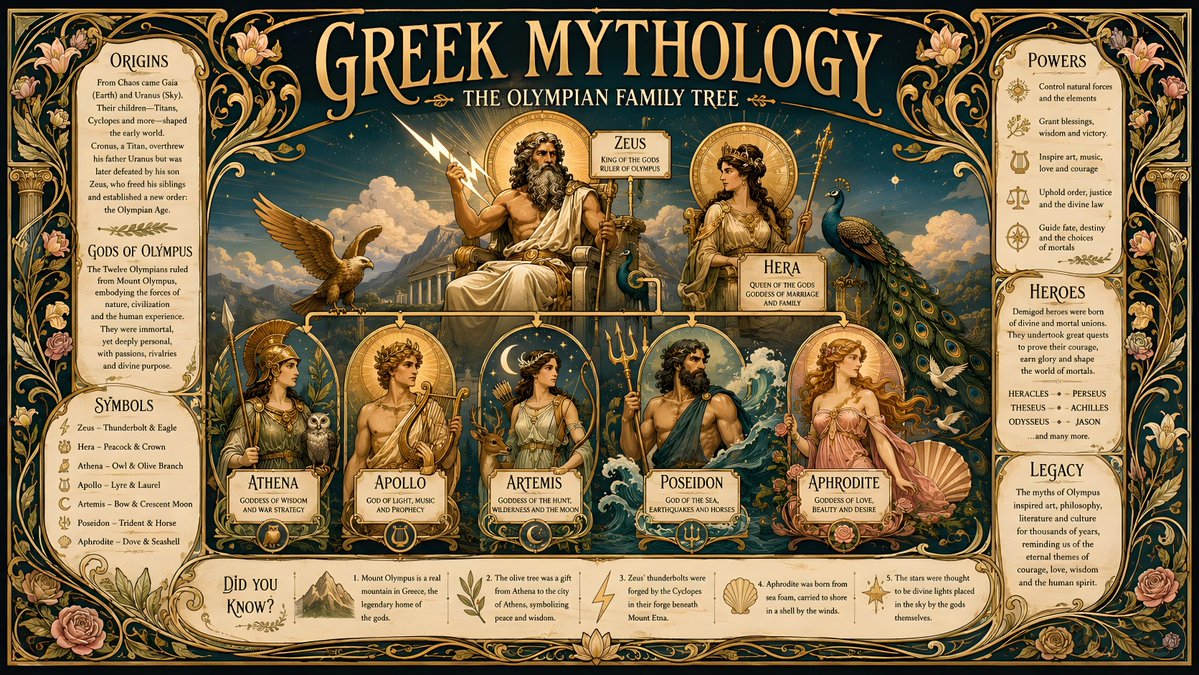
인포그래픽, 슬라이드, QR code: GPT Image 2 텍스트 워크플로
약 99%의 다국어 텍스트 정확도가 진짜 문서를 가능하게 합니다——하지만 모델이 데이터를 지어내므로 사실은 직접 검색해 prompt에 주입하세요.
텍스트 렌더링은 눈속임에서 도구로 선을 넘었다
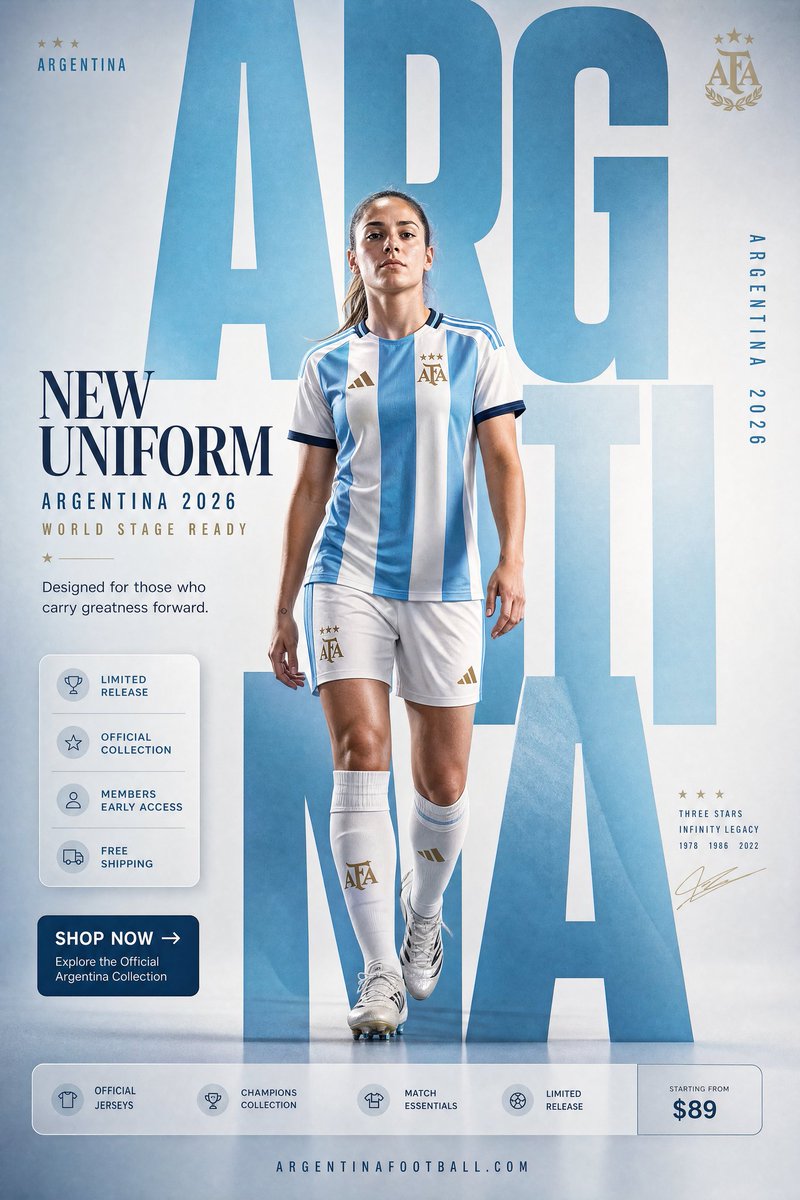
이미지 모델의 1세대 전체에서 텍스트는 곧 들통이었다. 간판은 유사 글자로 녹아내렸고, 차트는 노이즈로 무너졌으며, 문서 비슷한 것은 아예 논외였다. GPT Image 2가 그것을 바꿨다: 서드파티 보도는 그 문자 단위 텍스트 정확도를 10개가 넘는 문자 체계에서 약 99%로 본다——라틴 문자, 일본어, 한국어, 중국어, 힌디어, 벵골어, 아랍어 등——영어가 박힌 일본어나 서양 숫자와 나란히 흐르는 아랍어 같은 혼합 문자 레이아웃까지 포함해서다.
이 도약은 독립 테스트에서도 나타난다. 편집 벤치마크를 돌린 Hacker News 댓글 작성자들은 점수가 이전 버전의 3/12에서 새 모델의 10/12로 올랐다고 보고했고, VentureBeat의 출시 헤드라인은 이 카테고리 전환을 이렇게 요약했다: 다국어 텍스트, 완전한 인포그래픽, 슬라이드, 지도, 심지어 만화까지——거의 흠잡을 데 없이.
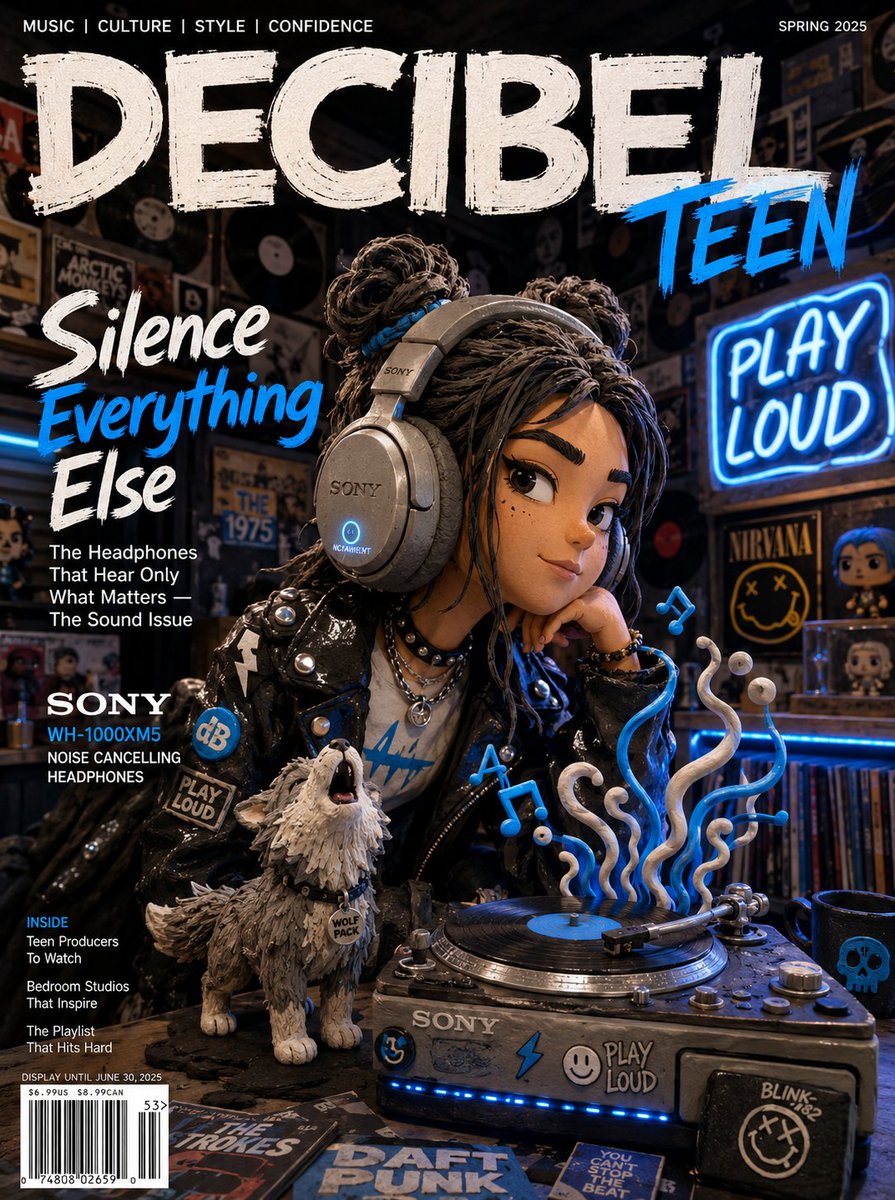
두 번째 재료는 글리프 자체만큼 중요하다: 모델은 밀집된 장면 안에서 100개 이상의 개별 객체를 일관되게 렌더링할 수 있다. 바로 그 밀도가 데이터 콜아웃, 작은 UI 라벨, 빽빽한 비교 차트를 텍스처로 무너지지 않고 읽을 수 있게 유지한다. 정확한 문자에 밀집 장면의 일관성이 더해진 것——이 조합이 예술 장난감을 문서 도구로 바꾼다.
지금 실제로 출시할 수 있는 것
한 모델 세대 전만 해도 불가능했던 한 무리의 산출물이 이제 prompt 한 줄 거리에 있다:
- 라벨이 붙은 섹션, 데이터 주석, 비교 차트를 갖춘 완전한 infographic
- 헤드라인, 본문, 차트를 한 프레임에 구성한 프레젠테이션 슬라이드
- 작동하고 스캔 가능한 QR code와 바코드를 디자인에 직접 임베드한 포스터와 패키지——Hacker News에서 회자된 '기상천외한 활용 사례' 글에서 실증되었다
- 라벨이 붙은 지역 지도, 대사가 들어간 멀티패널 만화, 잡지 스타일 레이아웃
- 제품 목업 안에서 가까이 읽어도 살아남는 작은 글씨의 UI 라벨
다국어 측면은 각주가 아니다. TechCrunch가 Sensor Tower와 Similarweb 데이터를 인용해 전한 바로는, 힌디어와 벵골어 렌더링 개선이 인도에서 지역 밈과 포스터 제작의 물결을 일으켰다——보도에 따르면 출시 주간에 인도에서 ChatGPT 다운로드가 약 500만 건, 미국은 약 200만 건으로, 이번 출시에서 측정 가능한 가장 큰 채택 스토리였다.
아무도 경고해 주지 않는 실패 모드
여기에 함정이 있다: 모델은 이제 텍스트를 완벽하게 렌더링하므로 그 출력은 권위 있어 보인다——그리고 그 텍스트의 내용을 자신만만하게 지어낸다. 성적 인포그래픽을 요청하면 그럴듯한 숫자를 발명한다. 널리 공유된 한 사례: 2026년 4월 런던 마라톤 성적 인포그래픽은 깔끔하고 읽기 쉽고 전문적으로 배치되었지만, 실제 세계 기록을 그냥 놓쳤다. 모든 문자는 정확하게 렌더링되었다——그 뒤의 사실이 틀렸을 뿐이다.
텍스트 정확성과 사실 정확성은 다른 속성이다. GPT Image 2는 뛰어난 식자공이자 형편없는 연구자다. 당신의 인포그래픽이 중요한 곳으로 간다면——클라이언트 덱, 보고서, 당신 이름이 걸린 소셜 계정——데이터를 모델이 공급하게 두어서는 안 된다.
커뮤니티에서 검증된 파이프라인은 단도직입적이다: 웹 검색은 직접 돌리고, 검색해 온 사실을 유일한 진실 공급원으로 prompt에 붙여 넣고, 모델에게 그것만 쓰라고 지시한다. 개발자들은 한 걸음 더 나아가, 모델 학습 기억 속 어떤 것도 믿지 않고 프로그램으로 데이터를 주입해 gpt-image-2 API를 직접 호출한다.
프로덕션 워크플로, 단계별로
- 먼저 리서치: 숫자, 이름, 날짜는 실제 출처에서 끌어오고, 결코 모델에서 가져오지 말 것
- 사실을 짧은 라벨 행(LABEL: value)으로 구조화하라——모델은 그것을 레이아웃 콘텐츠로 취급한다
- 레이아웃 언어를 지정하라: 섹션, 콜아웃, 차트 유형, 언어, 종횡비
- 생성한 뒤, 모든 수치를 출처 목록과 대조해 교정하라——'맞아 보이는지'가 아니라
이 워크플로를 진짜 작업에 맡겨 신뢰하기 전의 좋은 캘리브레이션 테스트는, 서드파티 테스터들이 다국어 렌더링을 검증하는 데 쓴 prompt다——모든 텍스트가 읽기 쉽고 철자가 정확하게 돌아왔다:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.진짜 산출물에는 사실 주입 템플릿으로 전환하라. DATA와 END DATA 사이의 모든 것은 당신 자신의 리서치에서 온다. 모델의 일은 순수하게 시각적이다. '추가하거나 추정하지 말라'는 지시가 하중을 떠받친다——그것이 없으면 모델은 '친절하게도' 지어낸 맥락으로 빈칸을 채우고, 게다가 완전히 설득력 있어 보인다:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
prompt를 프로덕션 인프라처럼 다뤄라
커뮤니티는 이미 그렇게 한다. 텍스트 정확도에 기대는 타이포그래피 포스터는 정리된 커뮤니티 prompt 템플릿 상위 10개 중 하나이며, wuyoscar/GPT-Image2-Skill 템플릿 저장소는 보도에 따르면 출시 약 6주 만에 2,862 stars와 253 forks에 도달했다——GitHub API로 검증 가능한 수치다. 사람들은 이 템플릿을 진귀한 수집품처럼이 아니라 코드처럼 버전 관리한다.
당신의 인포그래픽 워크플로에도 똑같이 하라: LAYOUT과 STYLE 블록은 고정하고 작업마다 DATA 블록만 교체하라. 그러면 출력이 시리즈 전체에서 시각적으로 일관되게 유지된다. 포스터와 텍스트 위주 레이아웃의 기성 출발점을 원한다면 https://gpt-img2.com/prompts 의 prompt 라이브러리를 둘러보라.
GPT Image 2는 무료로 시작할 수 있다——가입하면 20크레딧, 신용카드 불필요. 먼저 espresso 테스트 prompt를 돌려 텍스트 렌더링을 직접 확인하고, 그다음 당신이 직접 리서치한 데이터를 가져와 https://gpt-img2.com 에서 전체 워크플로를 시도해 보라.
Try these GPT Image 2 prompts