Infographies, diapositives et QR codes : le flux de texte de GPT Image 2
Une précision de texte multilingue de ~99% rend les vrais documents possibles, mais le modèle invente des données : cherchez vous-même les faits et injectez-les dans le prompt.
Le rendu de texte a franchi la ligne du gadget à l'outil
Pendant toute la première génération de modèles d'image, le texte était le révélateur. Les enseignes fondaient en pseudo-lettres, les graphiques se dissolvaient en bruit, et tout ce qui ressemblait à un document était tout simplement hors de question. GPT Image 2 a changé cela : la couverture par des tiers situe sa précision de texte au niveau du caractère à environ 99% sur plus de dix systèmes d'écriture — latin, japonais, coréen, chinois, hindi, bengali, arabe et d'autres — y compris des mises en page à écritures mixtes comme le japonais avec de l'anglais incrusté, ou l'arabe courant à côté de chiffres occidentaux.
Le bond apparaît aussi dans les tests indépendants. Des commentateurs de Hacker News qui faisaient tourner des benchmarks d'édition ont rapporté des scores passant de 3/12 sur les versions précédentes à 10/12 sur le nouveau modèle, et le titre de lancement de VentureBeat a résumé le changement de catégorie : texte multilingue, infographies complètes, diapositives, cartes, et même manga — apparemment sans faille.
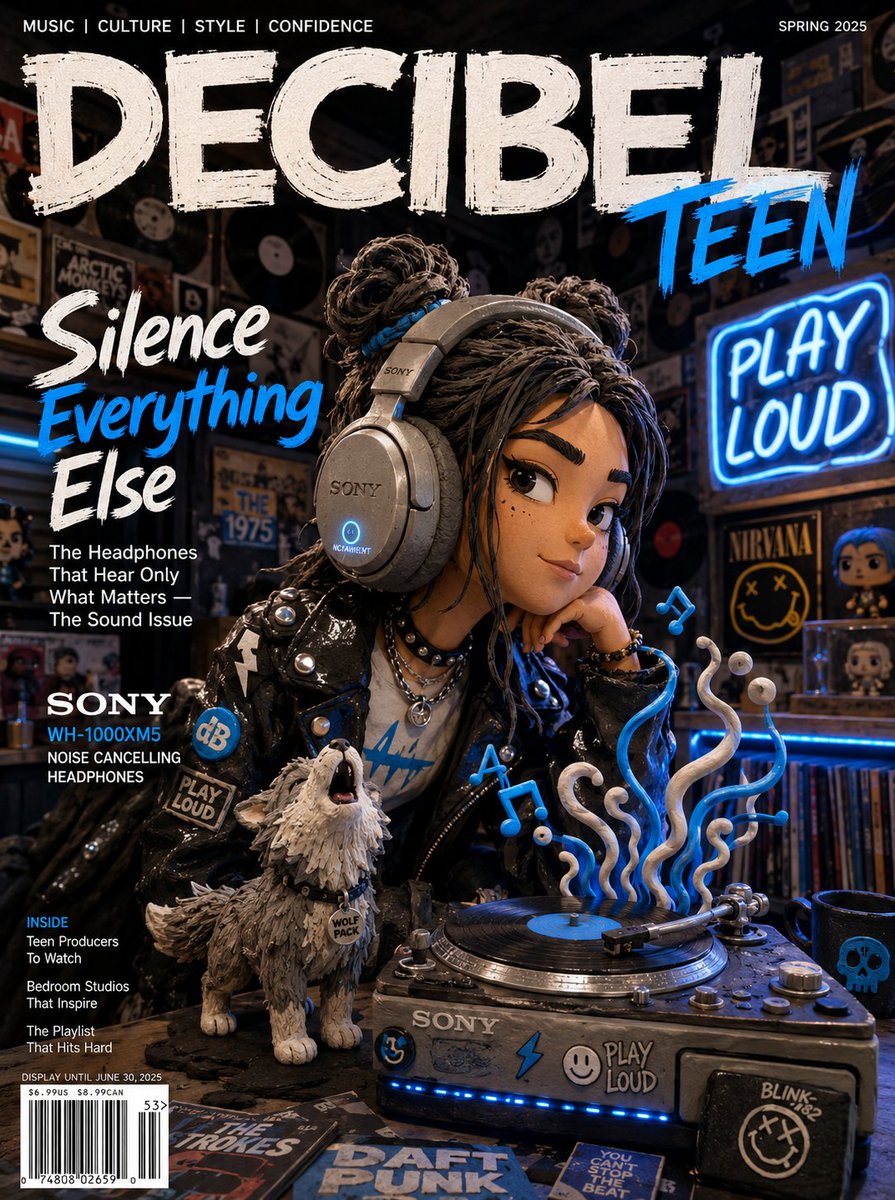
Le second ingrédient compte autant que les glyphes : le modèle peut rendre de façon cohérente plus de 100 objets distincts dans une scène dense. C'est cette densité qui garde lisibles les encadrés de données, les petites étiquettes d'UI et les graphiques comparatifs surchargés, au lieu de les faire s'effondrer en texture. Des caractères précis plus une cohérence de scène dense, voilà la combinaison qui transforme un jouet artistique en outil documentaire.
Ce que vous pouvez vraiment livrer maintenant
Toute une catégorie de livrables impossible il y a une génération de modèles n'est plus qu'à un prompt de distance :
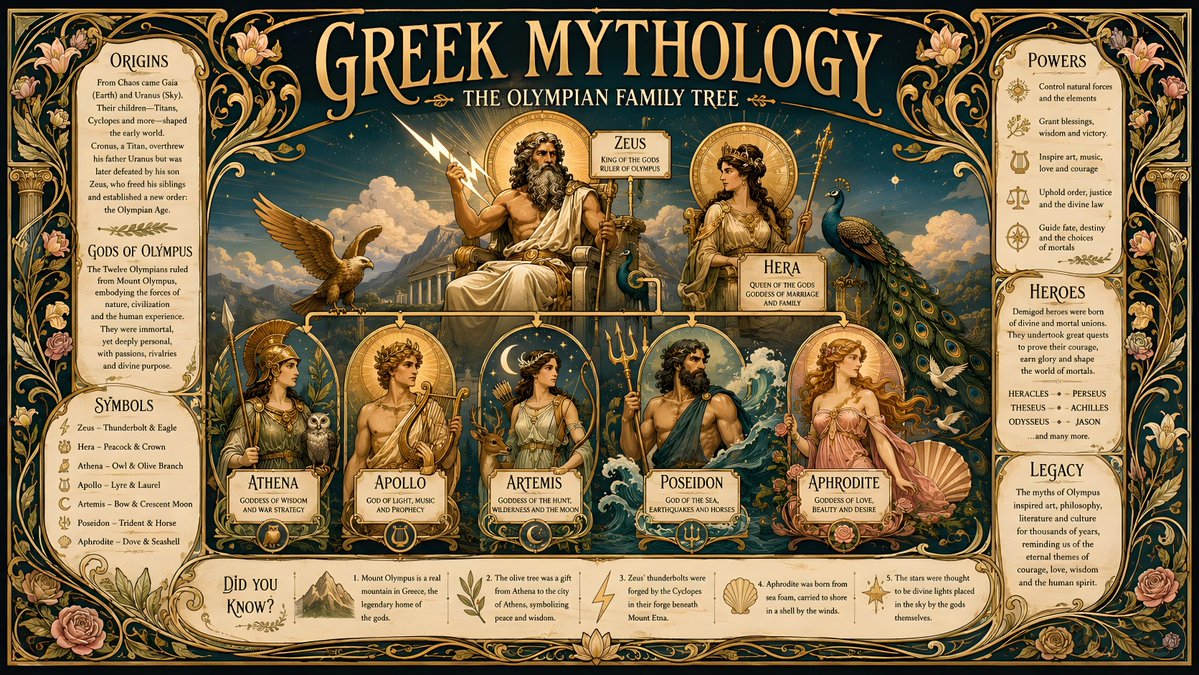
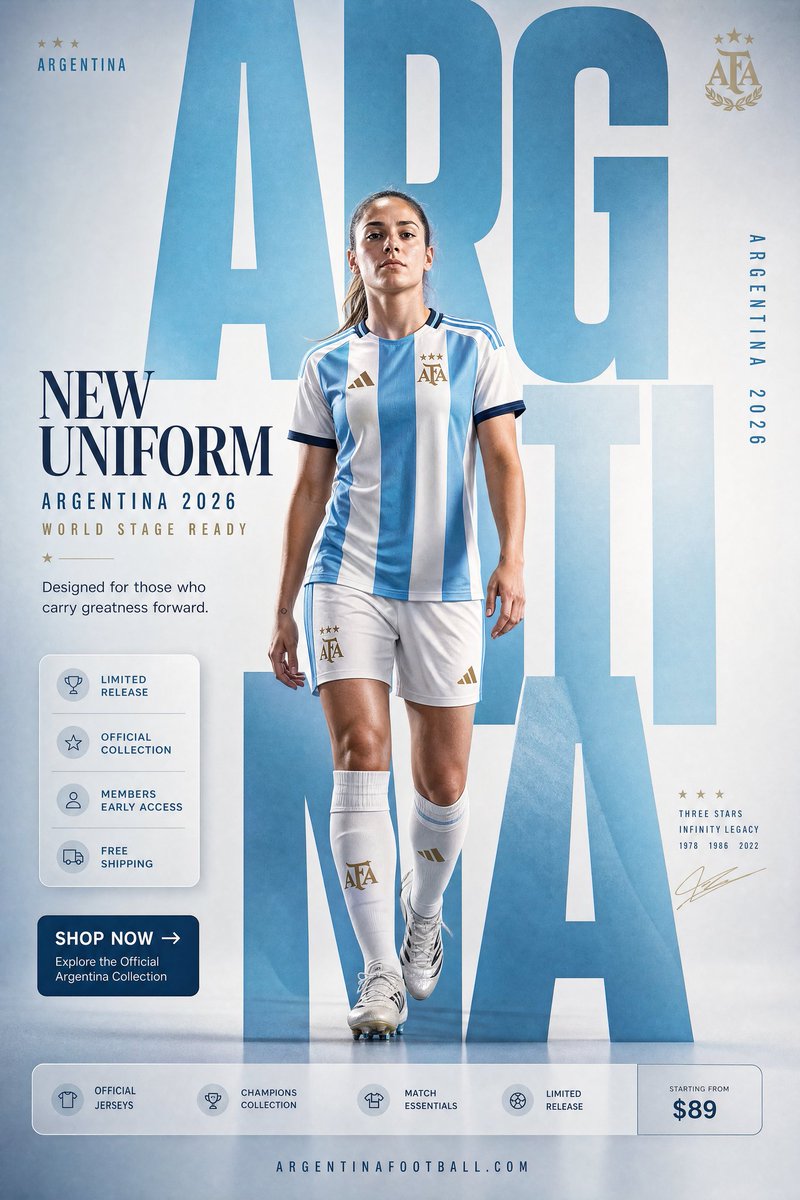
- Des infographies complètes avec des sections étiquetées, des annotations de données et des graphiques comparatifs
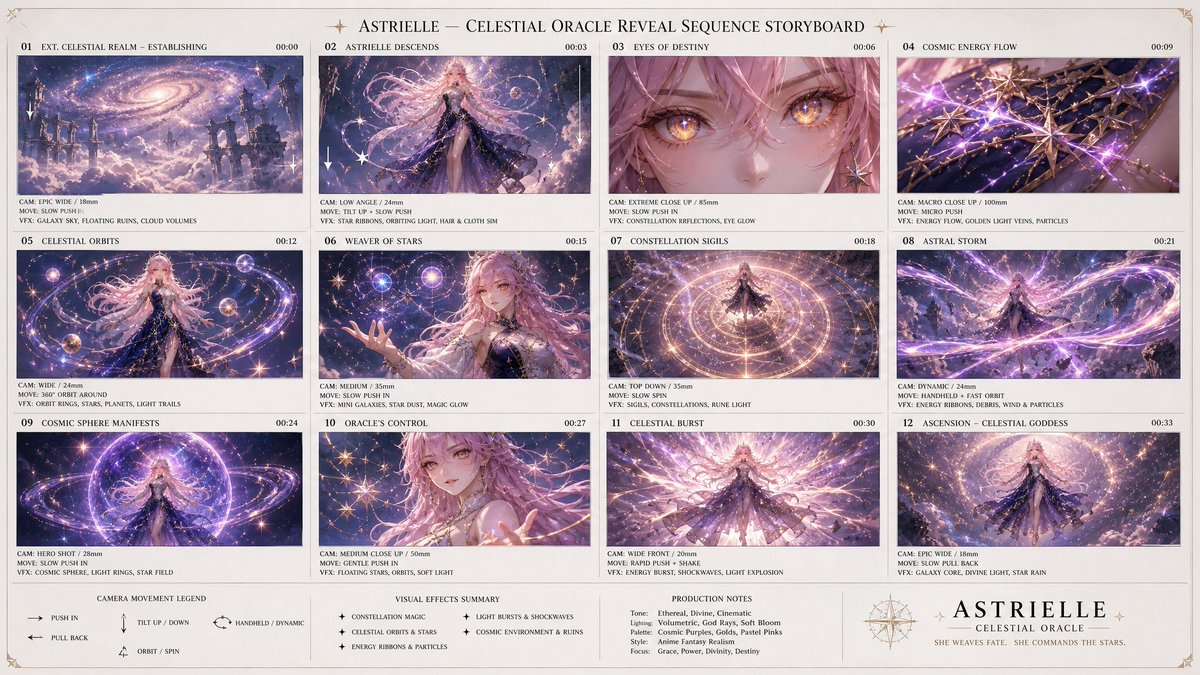
- Des diapositives de présentation avec titre, corps de texte et un graphique composés dans une seule image
- Des affiches et emballages avec des QR codes et codes-barres fonctionnels et scannables intégrés directement au design — démontré dans un article sur des usages déjantés qui a circulé sur Hacker News
- Des cartes avec régions étiquetées, des mangas multi-panneaux avec dialogues lettrés, des mises en page de style magazine
- Des étiquettes d'UI en petits caractères dans des maquettes de produit qui résistent à une lecture de près
Le volet multilingue n'est pas une note de bas de page. Selon TechCrunch, citant des données de Sensor Tower et Similarweb, l'amélioration du rendu du hindi et du bengali a alimenté une vague de création de mèmes et d'affiches régionaux en Inde — d'après les rapports, environ 5 millions de téléchargements de ChatGPT là-bas pendant la semaine de lancement contre environ 2 millions aux États-Unis, la plus grande histoire d'adoption mesurable du lancement.
Le mode de défaillance dont personne ne vous prévient
Voici le piège : le modèle rend désormais le texte parfaitement, donc sa sortie a l'air faisant autorité — et il fabriquera avec aplomb le contenu de ce texte. Demandez-lui une infographie de résultats et il inventera des chiffres plausibles. Un exemple très partagé : une infographie des résultats du marathon de Londres d'avril 2026, propre, lisible et mise en page de façon professionnelle, qui a tout simplement manqué le véritable record du monde. Chaque caractère était rendu correctement ; les faits derrière eux étaient faux.
La précision du texte et la précision factuelle sont des propriétés différentes. GPT Image 2 est un superbe typographe et un piètre chercheur. Si votre infographie va quelque part qui compte — une présentation client, un rapport, un compte social à votre nom — vous ne pouvez pas laisser le modèle fournir les données.
Le pipeline éprouvé par la communauté est sans détour : faites vous-même la recherche web, collez les faits récupérés dans le prompt comme unique source de vérité, et dites au modèle de n'utiliser que ceux-là. Les développeurs vont un cran plus loin et appellent directement l'API gpt-image-2 avec des données injectées par programmation, plutôt que de faire confiance à quoi que ce soit dans la mémoire d'entraînement du modèle.
Le flux de production, étape par étape
- Recherchez d'abord : tirez vos chiffres, noms et dates de sources réelles, jamais du modèle
- Structurez les faits en courtes lignes étiquetées (LABEL: value) — le modèle les traite comme du contenu de mise en page
- Précisez le langage de mise en page : sections, encadrés, type de graphique, langues, format d'image
- Générez, puis relisez chaque chiffre par rapport à votre liste de sources — pas par rapport à ce qui a l'air juste
Un bon test de calibrage avant de confier le flux à du vrai travail est le prompt que les testeurs tiers ont utilisé pour vérifier le rendu multilingue — tout le texte est revenu lisible et correctement orthographié :
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.Pour de vrais livrables, passez à un modèle d'injection de faits. Tout ce qui se trouve entre DATA et END DATA provient de votre propre recherche ; le travail du modèle est purement visuel. L'instruction de ne pas ajouter ni estimer est porteuse — sans elle, le modèle comblera obligeamment les lacunes avec un contexte inventé, et cela aura l'air parfaitement convaincant :
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
Traitez les prompts comme une infrastructure de production
La communauté le fait déjà. Les affiches typographiques qui s'appuient sur la précision du texte font partie des dix modèles de prompt communautaires consolidés du top, et le dépôt de modèles wuyoscar/GPT-Image2-Skill aurait atteint 2 862 stars et 253 forks en environ six semaines après le lancement — des chiffres vérifiables via l'API GitHub. Les gens versionnent ces modèles comme ils versionnent du code, et non comme ils collectionnent des curiosités.
Faites de même avec votre flux d'infographie : gardez les blocs LAYOUT et STYLE fixes, échangez le bloc DATA selon le travail, et votre sortie reste visuellement cohérente sur toute une série. Si vous voulez des points de départ prêts à l'emploi pour des affiches et des mises en page chargées de texte, parcourez la bibliothèque de prompts sur https://gpt-img2.com/prompts.
GPT Image 2 est gratuit pour commencer — vous obtenez 20 crédits à l'inscription, sans carte de crédit. Lancez d'abord le prompt de test de l'espresso pour voir le rendu de texte par vous-même, puis apportez vos propres données recherchées et essayez le flux complet sur https://gpt-img2.com.
Try these GPT Image 2 prompts
Essayez ces techniques maintenant
Ouvrez le générateur GPT Image 2 gratuit et passez à la pratique — 20 crédits gratuits, sans carte de crédit.