Infográficos, slides e QR codes: o fluxo de texto do GPT Image 2
Uma precisão de texto multilíngue de ~99% torna possíveis documentos reais — mas o modelo inventa dados, então pesquise os fatos você mesmo e injete-os no prompt.
A renderização de texto cruzou a linha de truque para ferramenta
Durante toda a primeira geração de modelos de imagem, o texto era o que entregava o jogo. As placas derretiam em pseudoletras, os gráficos se dissolviam em ruído e qualquer coisa parecida com um documento estava simplesmente fora de cogitação. O GPT Image 2 mudou isso: a cobertura de terceiros coloca sua precisão de texto em nível de caractere em torno de 99% em mais de dez sistemas de escrita — latino, japonês, coreano, chinês, hindi, bengali, árabe e outros —, incluindo layouts de escrita mista como japonês com inglês embutido ou árabe correndo ao lado de números ocidentais.
O salto também aparece em testes independentes. Comentaristas do Hacker News que rodavam benchmarks de edição relataram pontuações subindo de 3/12 em versões anteriores para 10/12 no novo modelo, e a manchete de lançamento do VentureBeat resumiu a mudança de categoria: texto multilíngue, infográficos completos, slides, mapas, até mangá — aparentemente sem falhas.
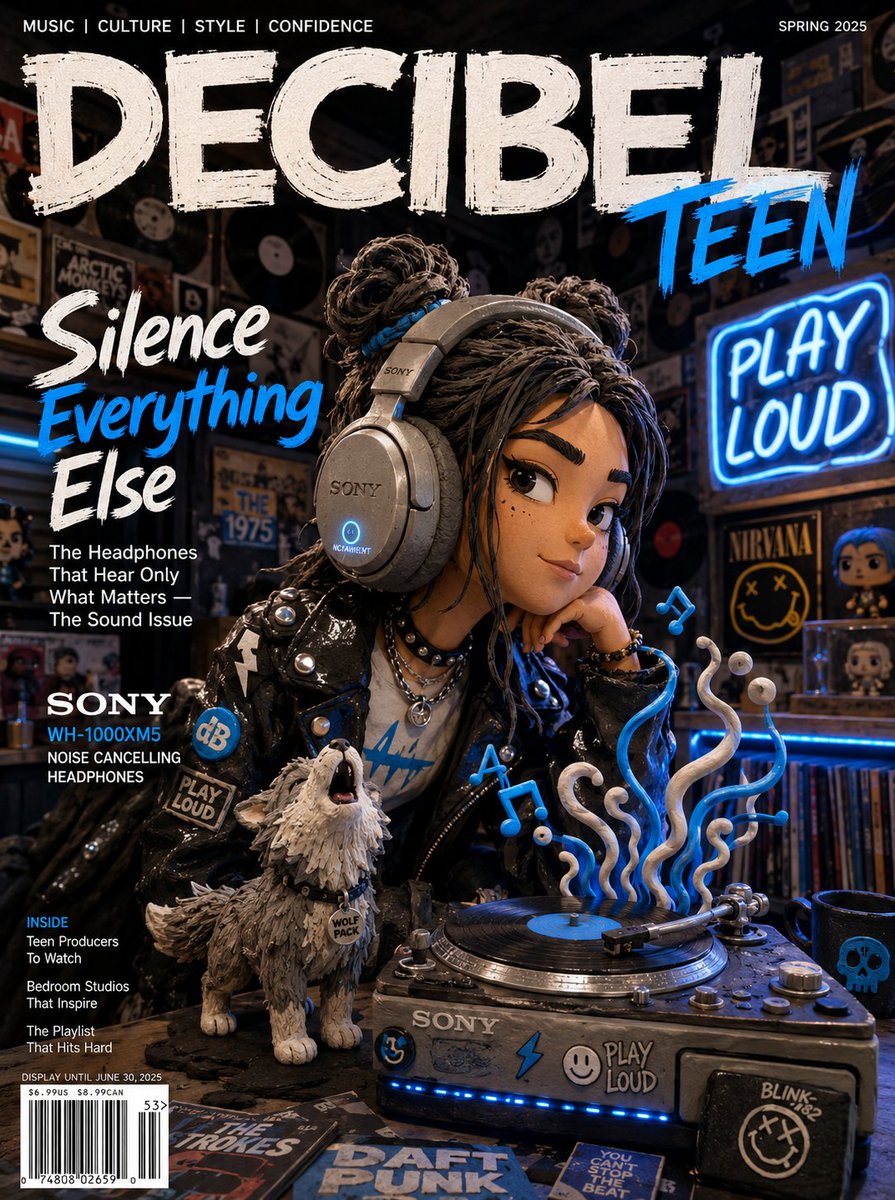
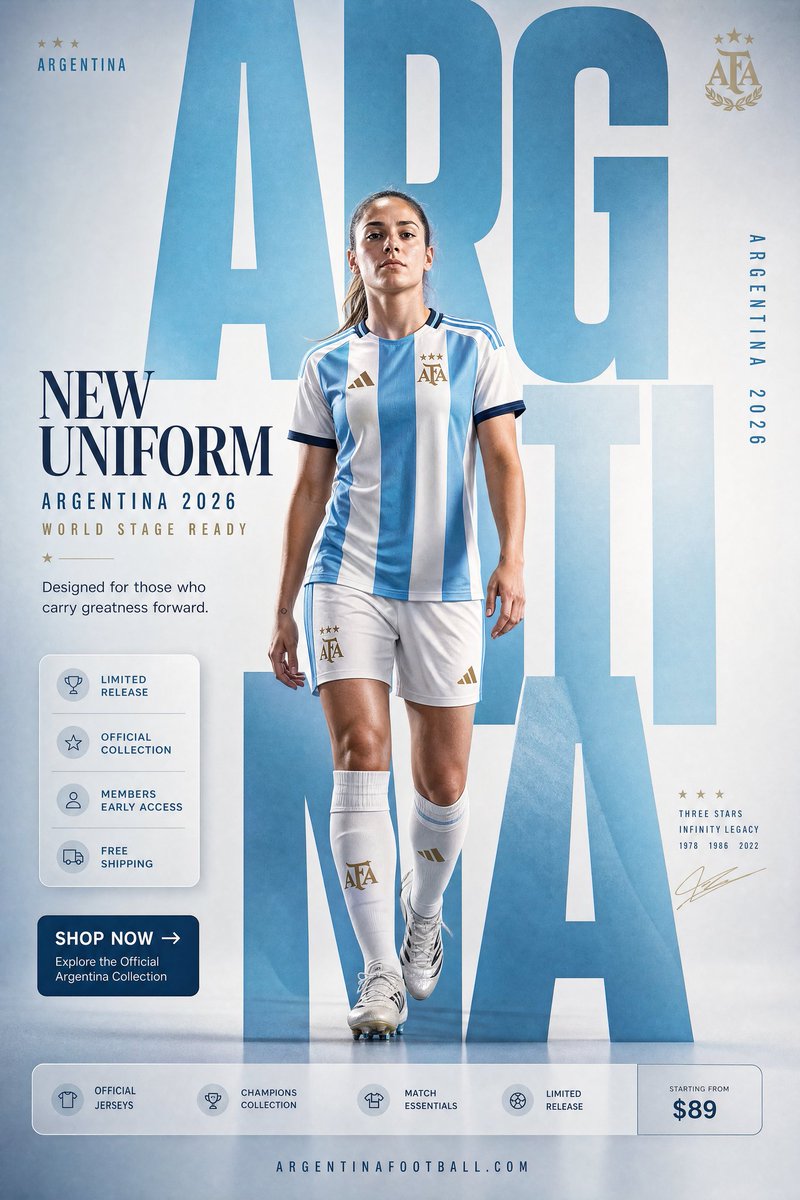
O segundo ingrediente importa tanto quanto os glifos: o modelo consegue renderizar de forma coerente mais de 100 objetos distintos em uma cena densa. Essa densidade é o que mantém legíveis as anotações de dados, os pequenos rótulos de UI e os gráficos comparativos lotados, em vez de fazê-los colapsar em textura. Caracteres precisos somados à coerência de cena densa é a combinação que transforma um brinquedo artístico em uma ferramenta de documentos.
O que você realmente pode entregar agora
Toda uma categoria de entregáveis que era impossível há uma geração de modelos está agora a um único prompt de distância:
- Infográficos completos com seções rotuladas, anotações de dados e gráficos comparativos
- Slides de apresentação com título, corpo de texto e um gráfico compostos em um único quadro
- Pôsteres e embalagens com QR codes e códigos de barras funcionais e escaneáveis embutidos diretamente no design — demonstrado em um artigo sobre usos malucos que circulou no Hacker News
- Mapas com regiões rotuladas, mangás de múltiplos painéis com diálogos legendados, layouts no estilo revista
- Rótulos de UI em letra miúda em mockups de produto que sobrevivem a uma leitura de perto
O lado multilíngue não é uma nota de rodapé. Segundo o TechCrunch, citando dados da Sensor Tower e da Similarweb, a melhoria na renderização de hindi e bengali alimentou uma onda de criação de memes e pôsteres regionais na Índia — segundo os relatos, cerca de 5 milhões de downloads do ChatGPT lá durante a semana de lançamento contra cerca de 2 milhões nos EUA, a maior história de adoção mensurável do lançamento.
O modo de falha do qual ninguém te avisa
Aqui está a armadilha: o modelo agora renderiza o texto perfeitamente, então sua saída parece ter autoridade — e ele fabricará com toda a confiança o conteúdo desse texto. Peça um infográfico de resultados e ele inventará números plausíveis. Um exemplo muito compartilhado: um infográfico de resultados da Maratona de Londres de abril de 2026 que era limpo, legível e diagramado profissionalmente, e que simplesmente errou o recorde mundial real. Cada caractere foi renderizado corretamente; os fatos por trás deles estavam errados.
Precisão de texto e precisão factual são propriedades diferentes. O GPT Image 2 é um tipógrafo soberbo e um pesquisador fraco. Se o seu infográfico vai para algum lugar que importa — um deck de cliente, um relatório, uma conta social com o seu nome —, você não pode deixar o modelo fornecer os dados.
O pipeline comprovado pela comunidade é direto: faça você mesmo a busca na web, cole os fatos recuperados no prompt como a única fonte de verdade e diga ao modelo para usar apenas esses. Os desenvolvedores vão um passo além e chamam a API gpt-image-2 diretamente com dados injetados programaticamente, em vez de confiar em qualquer coisa na memória de treinamento do modelo.
O fluxo de produção, passo a passo
- Pesquise primeiro: extraia seus números, nomes e datas de fontes reais, nunca do modelo
- Estruture os fatos como linhas curtas rotuladas (LABEL: value) — o modelo as trata como conteúdo de layout
- Especifique a linguagem do layout: seções, destaques, tipo de gráfico, idiomas, proporção
- Gere e depois revise cada número contra sua lista de fontes — não contra o que parece certo
Um bom teste de calibração antes de confiar o fluxo a trabalho real é o prompt que os testadores terceirizados usaram para verificar a renderização multilíngue — todo o texto voltou legível e corretamente grafado:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.Para entregáveis reais, mude para um modelo de injeção de fatos. Tudo entre DATA e END DATA vem da sua própria pesquisa; o trabalho do modelo é puramente visual. A instrução de não adicionar nem estimar é estrutural — sem ela, o modelo preencherá prestativamente as lacunas com contexto inventado, e parecerá completamente convincente:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
Trate os prompts como infraestrutura de produção
A comunidade já faz isso. Os pôsteres tipográficos que se apoiam na precisão do texto são um dos dez modelos de prompt consolidados da comunidade, e o repositório de modelos wuyoscar/GPT-Image2-Skill teria atingido 2.862 stars e 253 forks em cerca de seis semanas após o lançamento — números verificáveis pela API do GitHub. As pessoas versionam esses modelos como versionam código, não como colecionam curiosidades.
Faça o mesmo com o seu fluxo de infográficos: mantenha fixos os blocos LAYOUT e STYLE, troque o bloco DATA por trabalho, e a sua saída permanece visualmente consistente ao longo de toda uma série. Se você quer pontos de partida prontos para pôsteres e layouts carregados de texto, explore a biblioteca de prompts em https://gpt-img2.com/prompts.
O GPT Image 2 é gratuito para começar — você recebe 20 créditos ao se cadastrar, sem cartão de crédito. Rode primeiro o prompt de teste do espresso para ver a renderização de texto por conta própria, e depois traga seus próprios dados pesquisados e experimente o fluxo completo em https://gpt-img2.com.
Try these GPT Image 2 prompts
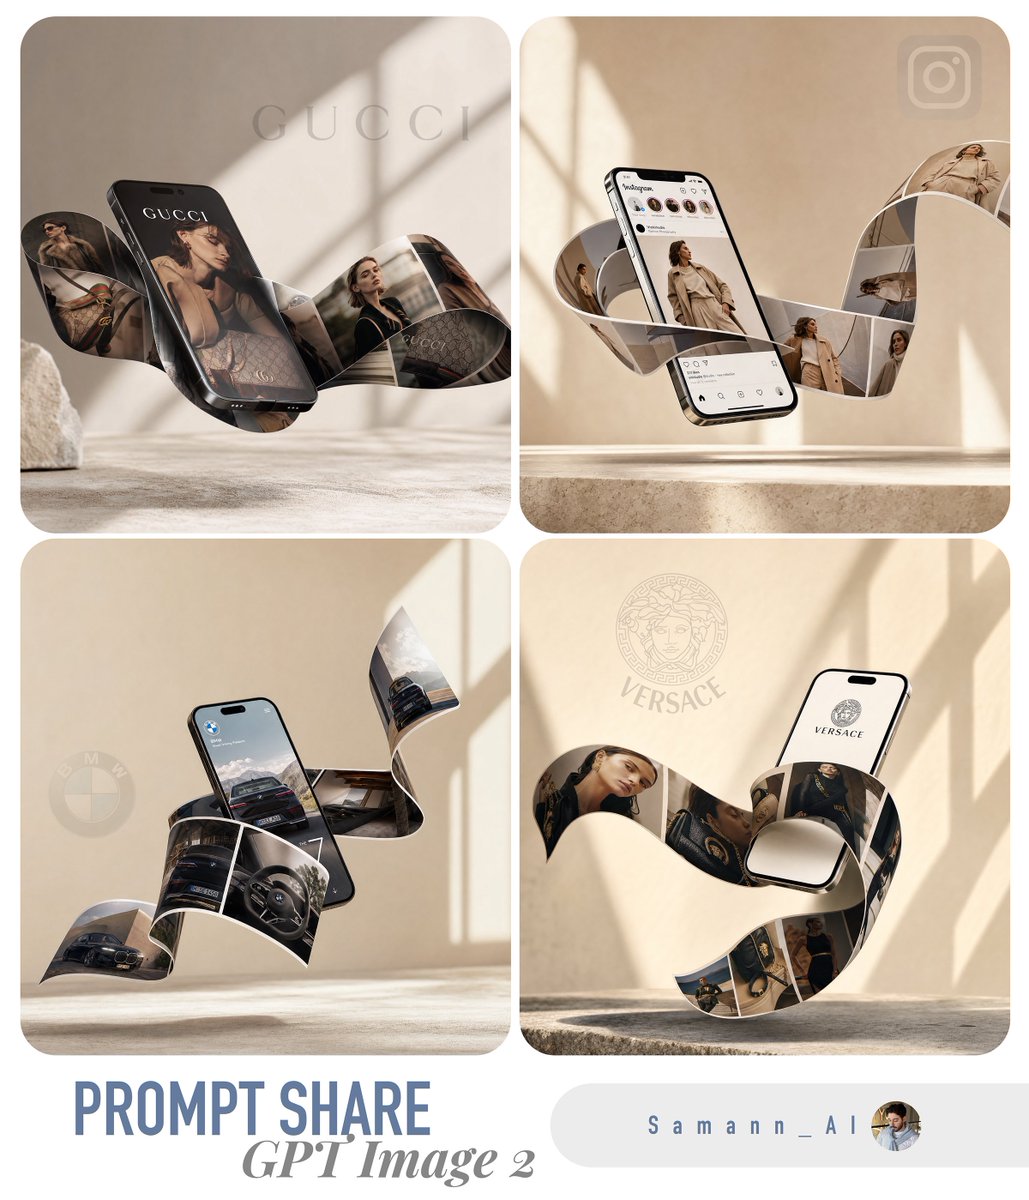
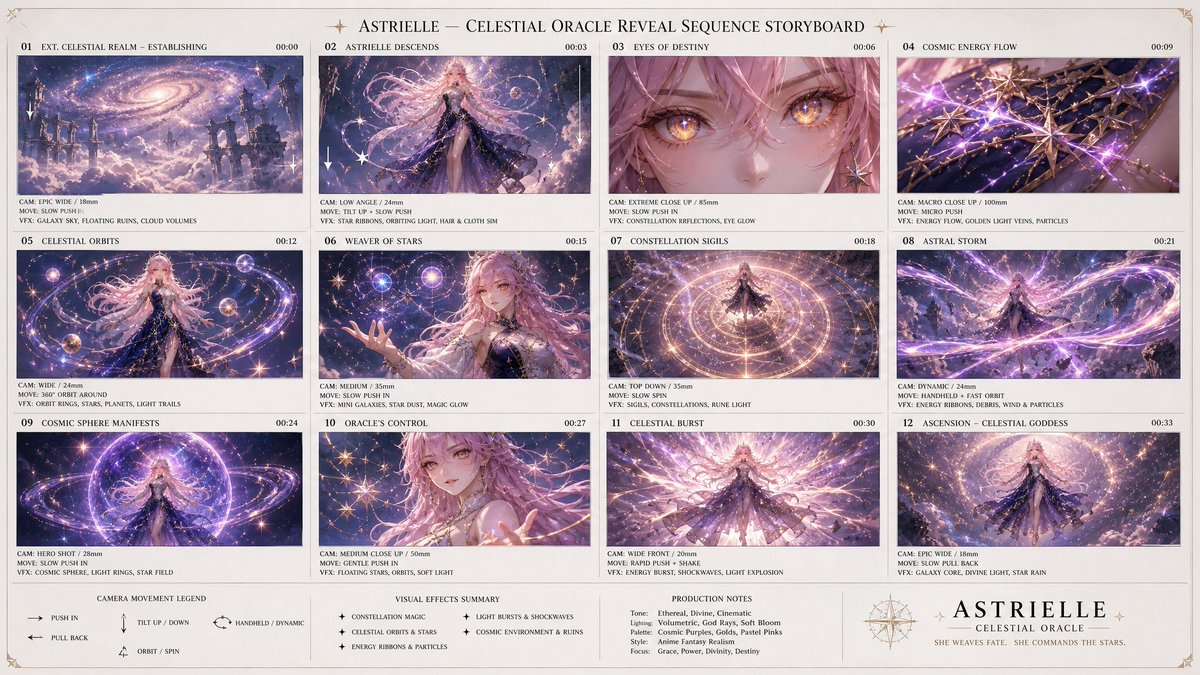
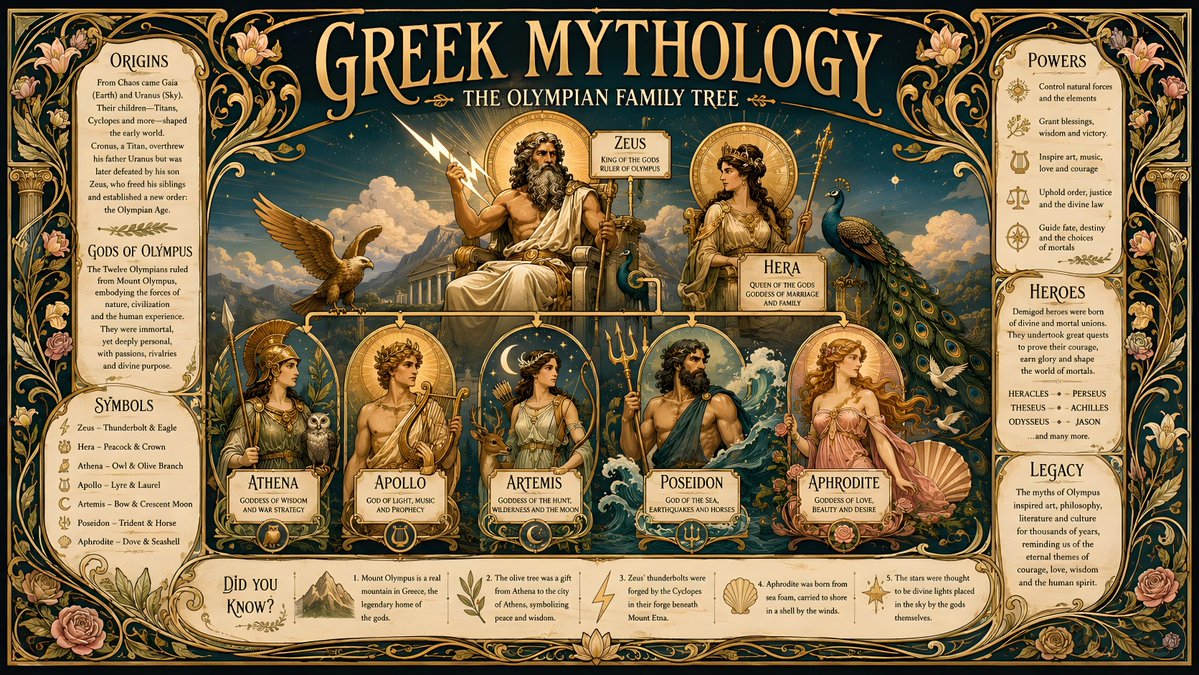
Experimente estas técnicas agora
Abra o gerador gratuito do GPT Image 2 e coloque em prática — 20 créditos grátis, sem cartão de crédito.