資訊圖、簡報與 QR code:GPT Image 2 文字工作流
約 99% 的多語言文字準確率讓真實文件成為可能——但模型會捏造資料,所以請自己去搜尋事實,再把它們注入 prompt。
文字渲染從噱頭跨進了工具的門檻
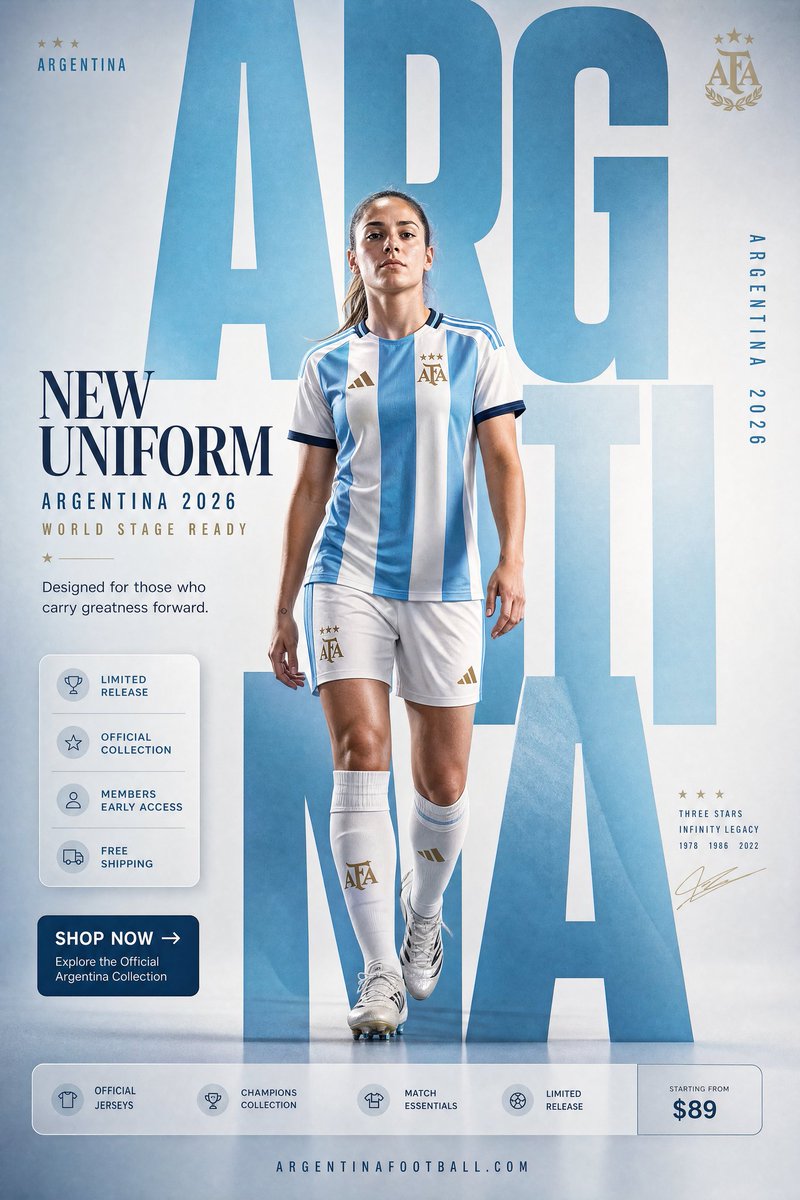
在影像模型的整個第一代裡,文字就是破綻。招牌融化成偽字母,圖表瓦解成雜訊,任何像文件的東西都根本無從談起。GPT Image 2 改變了這一點:第三方報導把它的字元級文字準確率定在十多種文字系統下約 99%——拉丁文、日文、韓文、中文、印地文、孟加拉文、阿拉伯文等等——包括混合文字系統的版式,比如嵌入英文的日文,或與西文數字並排的阿拉伯文。
這種躍升在獨立測試裡同樣顯現。Hacker News 上跑編輯基準的評論者報告說,分數從早期版本的 3/12 升到了新模型的 10/12,而 VentureBeat 的發布標題概括了這一品類層面的轉變:多語言文字、完整資訊圖、簡報、地圖,乃至漫畫——看上去幾乎毫無瑕疵。
第二個要素和字形本身一樣關鍵:模型能在一個密集場景裡連貫地渲染 100+ 個互不相同的物件。正是這種密度讓資料標注、細小的 UI 標籤和擁擠的對比圖表保持清晰,而不是塌縮成紋理。準確的字元加上密集場景的連貫性,正是把一個藝術玩具變成文件工具的組合。
你現在真正能交付的東西
上一個模型世代還不可能做到的一整類交付物,如今只差一句 prompt:
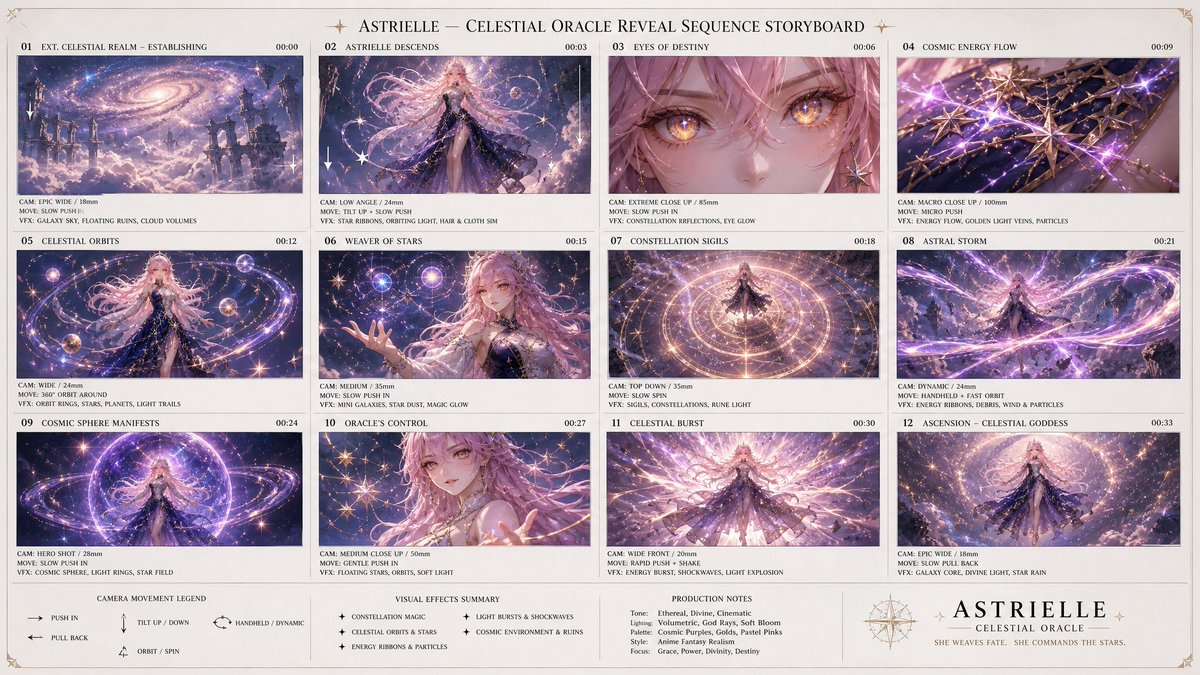
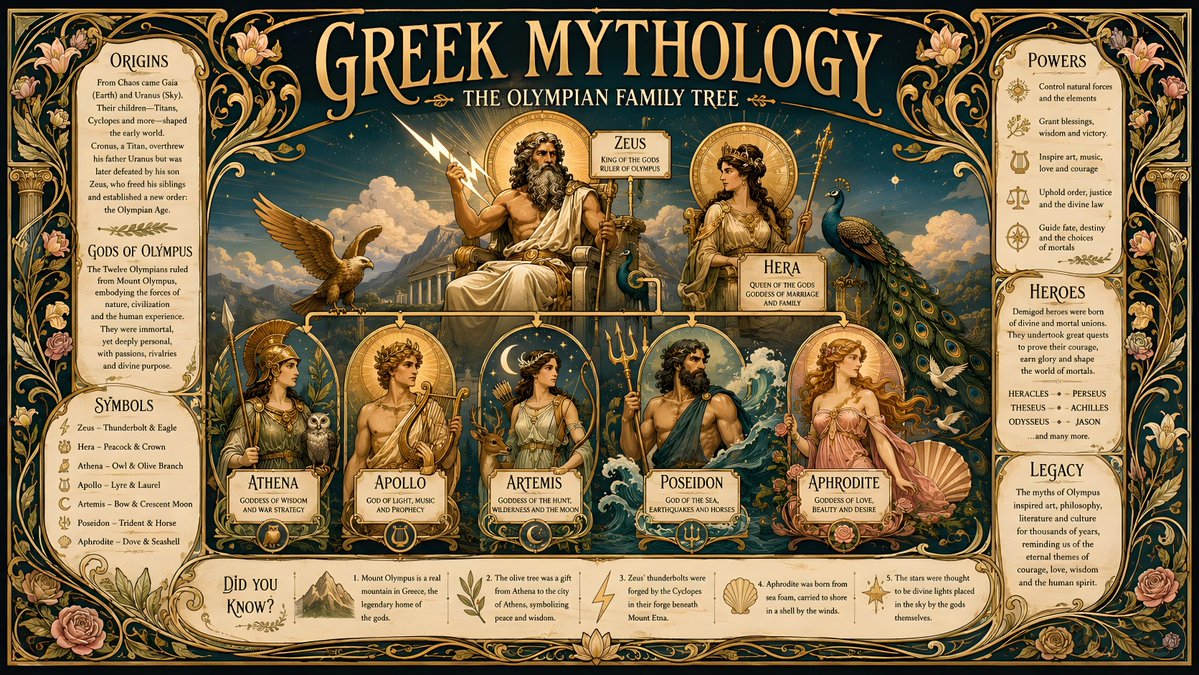
- 帶標注分區、資料注釋和對比圖表的完整 infographic
- 在一幀裡組合好標題、內文與圖表的簡報投影片
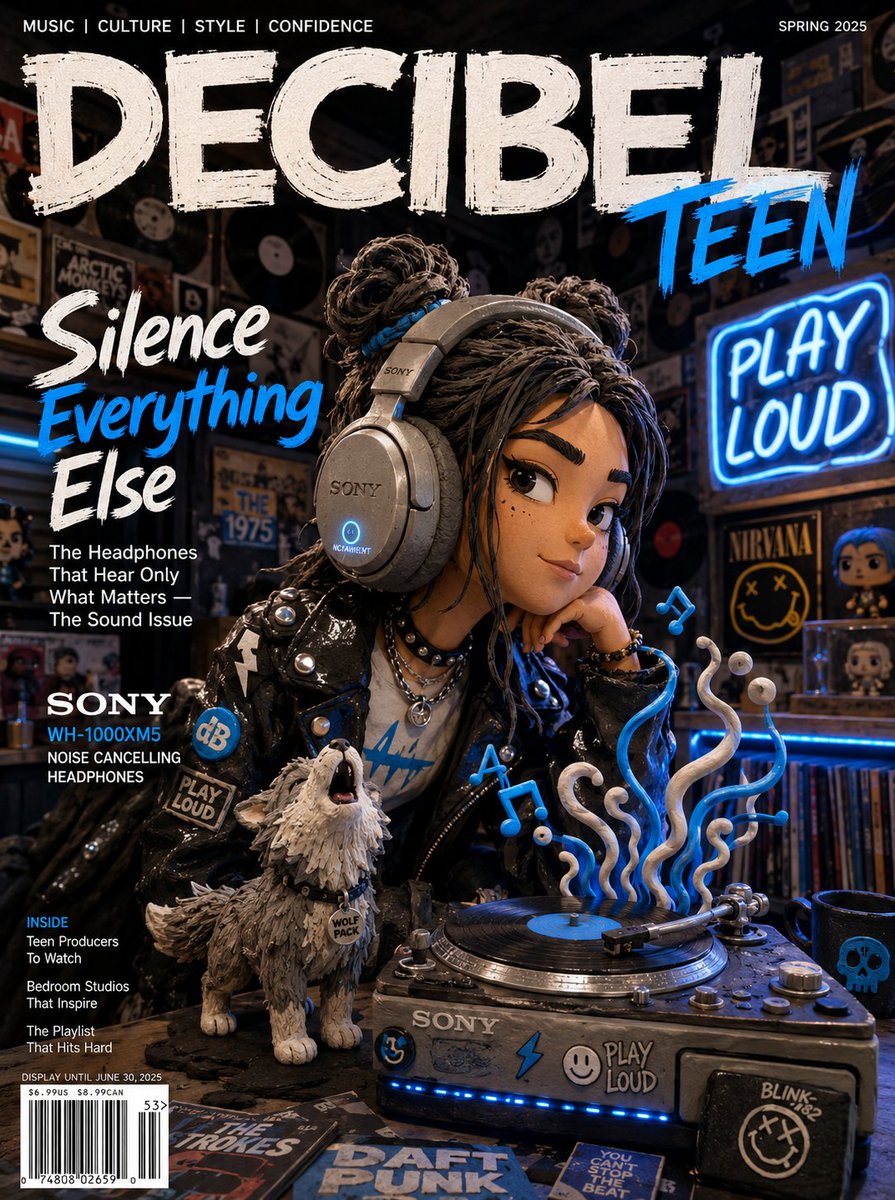
- 把可用、可掃描的 QR code 和條碼直接嵌入設計的海報與包裝——這在一篇曾在 Hacker News 上廣為流傳的「奇葩用例」文章裡有過演示
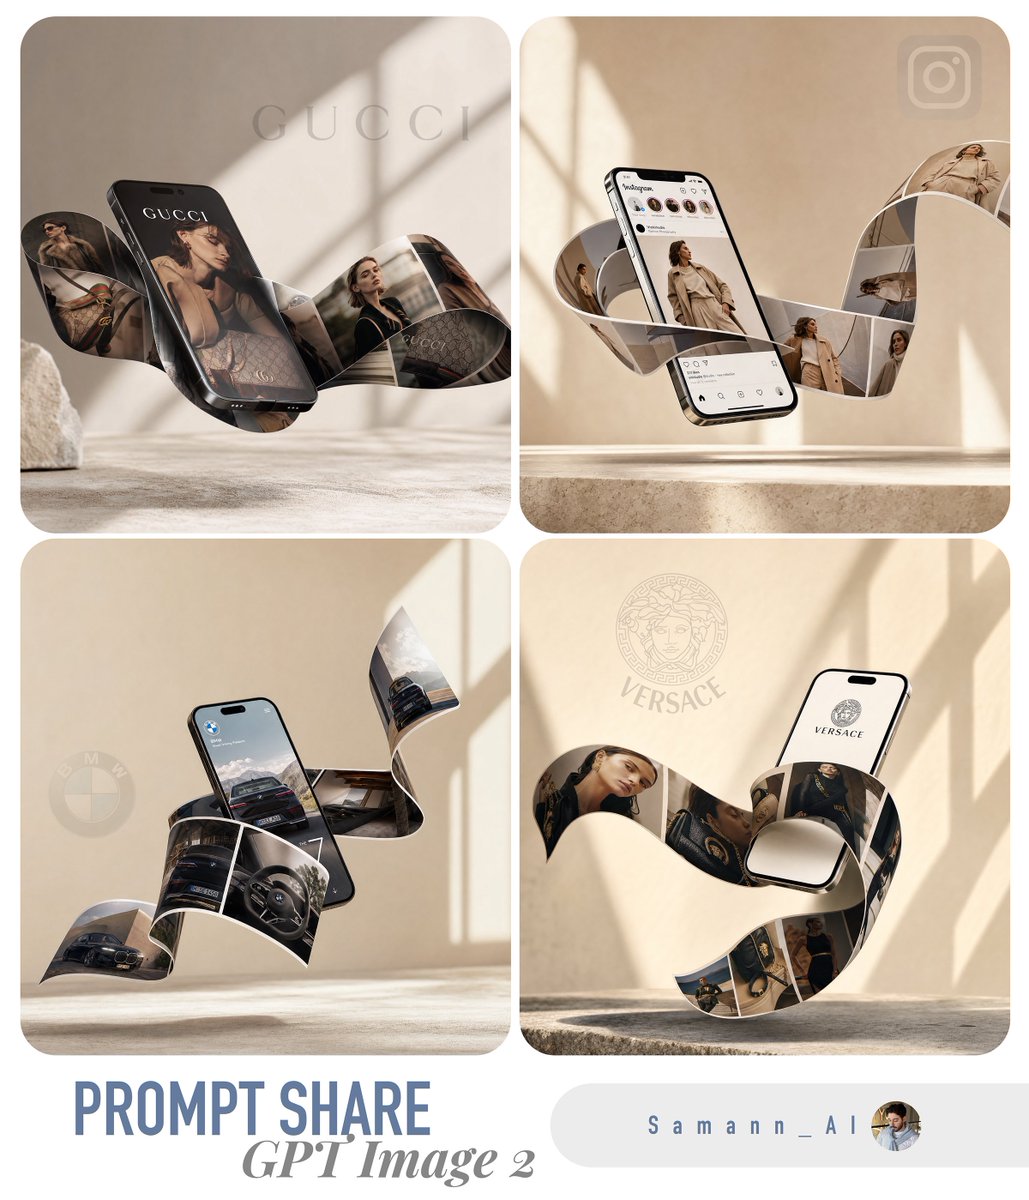
- 帶標注區域的地圖、配字對白的多格漫畫、雜誌風版式
- 產品 mockup 裡經得起細看的小號 UI 標籤
多語言這一面絕非腳註。據 TechCrunch 引用 Sensor Tower 與 Similarweb 的資料,印地文與孟加拉文渲染的改進在印度掀起了一波區域性迷因與海報創作——據報導發布週期間在印度約有 500 萬次 ChatGPT 下載,而美國約為 200 萬次,是這次發布中可量化的最大採用故事。
沒人提醒你的那種失敗模式
陷阱在這裡:模型現在能把文字渲染得完美無瑕,所以它的輸出看起來很權威——而它會自信滿滿地捏造那些文字的內容。讓它做一張成績資訊圖,它就會捏造出一組看似合理的數字。一個被廣泛分享的例子:一張 2026 年 4 月倫敦馬拉松成績資訊圖,乾淨、清晰、排版專業,卻乾脆漏掉了實際的世界紀錄。每一個字元都渲染正確;字元背後的事實卻是錯的。
文字準確和事實準確是兩種不同的屬性。GPT Image 2 是個出色的排版師,卻是個糟糕的研究者。如果你的資訊圖要去往任何重要的地方——客戶簡報稿、報告、署著你名字的社群帳號——你就不能讓模型來提供資料。
社群驗證過的流程很直白:自己去跑網路搜尋,把檢索到的事實作為唯一事實來源貼進 prompt,並告訴模型只用這些。開發者還更進一步,直接呼叫 gpt-image-2 API,以程式化方式注入資料,而不是去信任模型訓練記憶裡的任何東西。
生產工作流,分步拆解
- 先研究:從真實來源拉取你的數字、名稱和日期,絕不從模型那裡取
- 把事實結構化成簡短的帶標籤行(LABEL: value)——模型會把它們當作版式內容處理
- 指定版式語言:分區、標注、圖表類型、語言、長寬比
- 生成後,逐一對照你的來源清單核校每個數字——而不是對照「看起來對不對」
在你信任這套工作流去做真正的工作之前,一個好的校準測試就是第三方測試者用來驗證多語言渲染的那條 prompt——所有文字都返回得可讀且拼寫正確:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.對於真正的交付物,切換到一個事實注入模板。DATA 與 END DATA 之間的一切都來自你自己的研究;模型的工作純粹是視覺。那條「不要添加或估算」的指令是承重的——沒有它,模型會「熱心地」用捏造的上下文填補空白,而且看起來會非常令人信服:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
把 prompt 當作生產基礎設施來對待
社群已經這麼做了。倚賴文字準確度的排版海報,是被整理出來的十大社群 prompt 模板之一,而 wuyoscar/GPT-Image2-Skill 模板倉庫據報導在發布約六週內達到了 2,862 stars 和 253 forks——這些數字可透過 GitHub API 核實。人們給這些模板做版本管理,就像給程式碼做版本管理一樣,而不是當作獵奇藏品來收集。
對你的資訊圖工作流也照做:把 LAYOUT 與 STYLE 區塊固定下來,每個任務只替換 DATA 區塊,你的輸出就能在一整個系列裡保持視覺一致。如果你想要海報和文字密集版式的現成起點,可在 https://gpt-img2.com/prompts 瀏覽 prompt 庫。
GPT Image 2 可免費開始——註冊即得 20 個積分,無需信用卡。先跑那條 espresso 測試 prompt,親眼看看文字渲染,然後帶上你自己研究好的資料,到 https://gpt-img2.com 試一試完整工作流。
Try these GPT Image 2 prompts