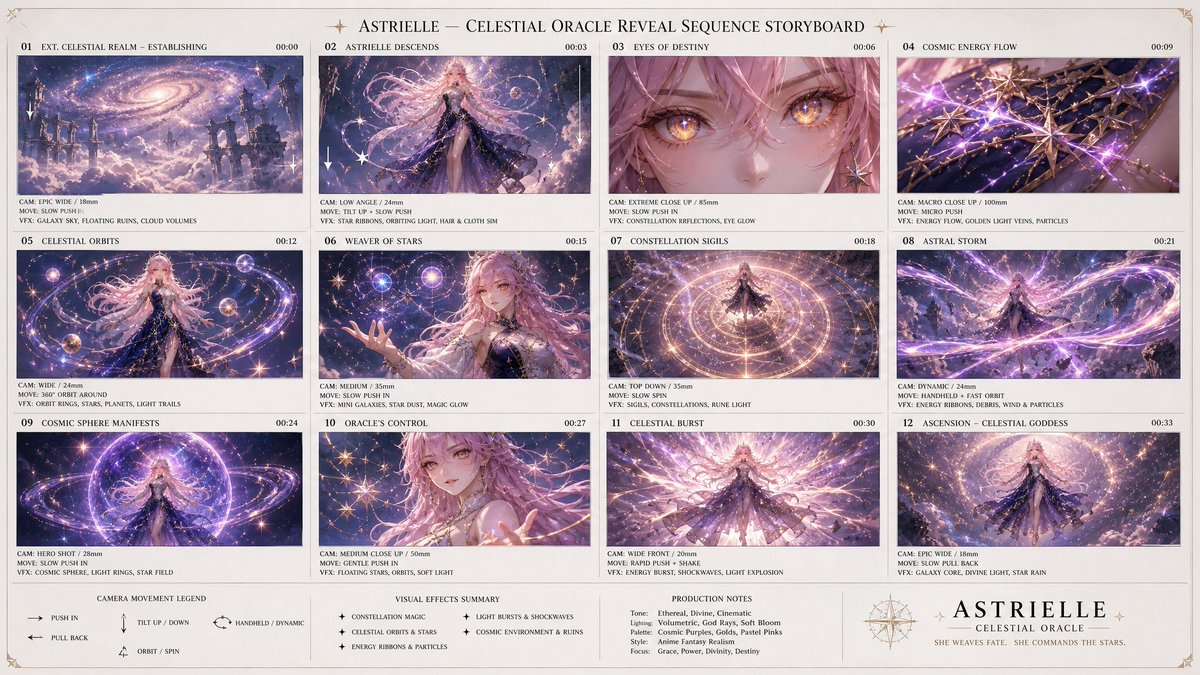
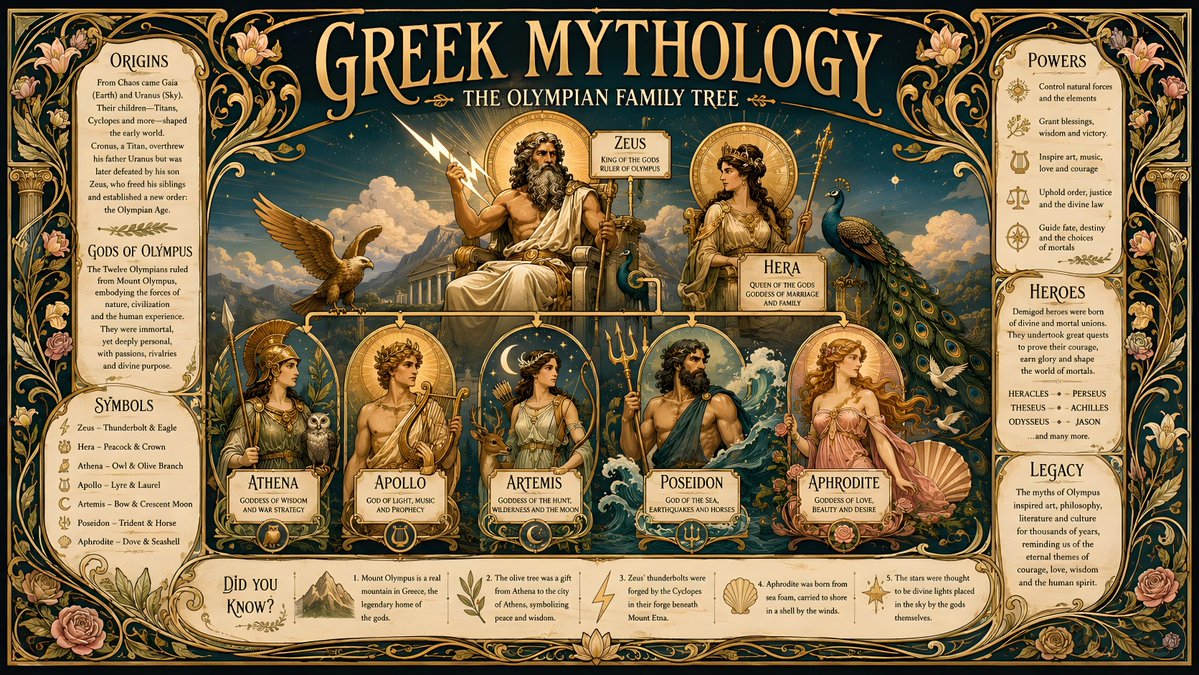
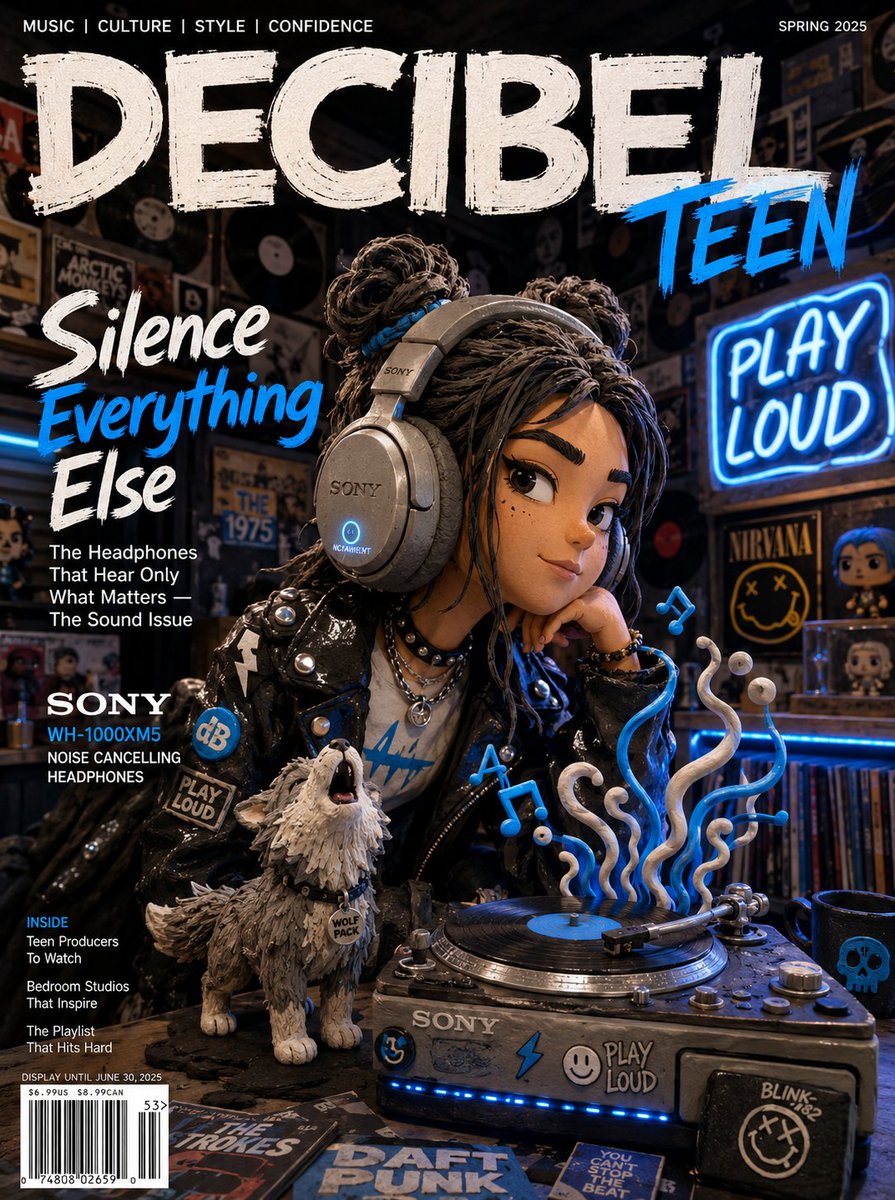
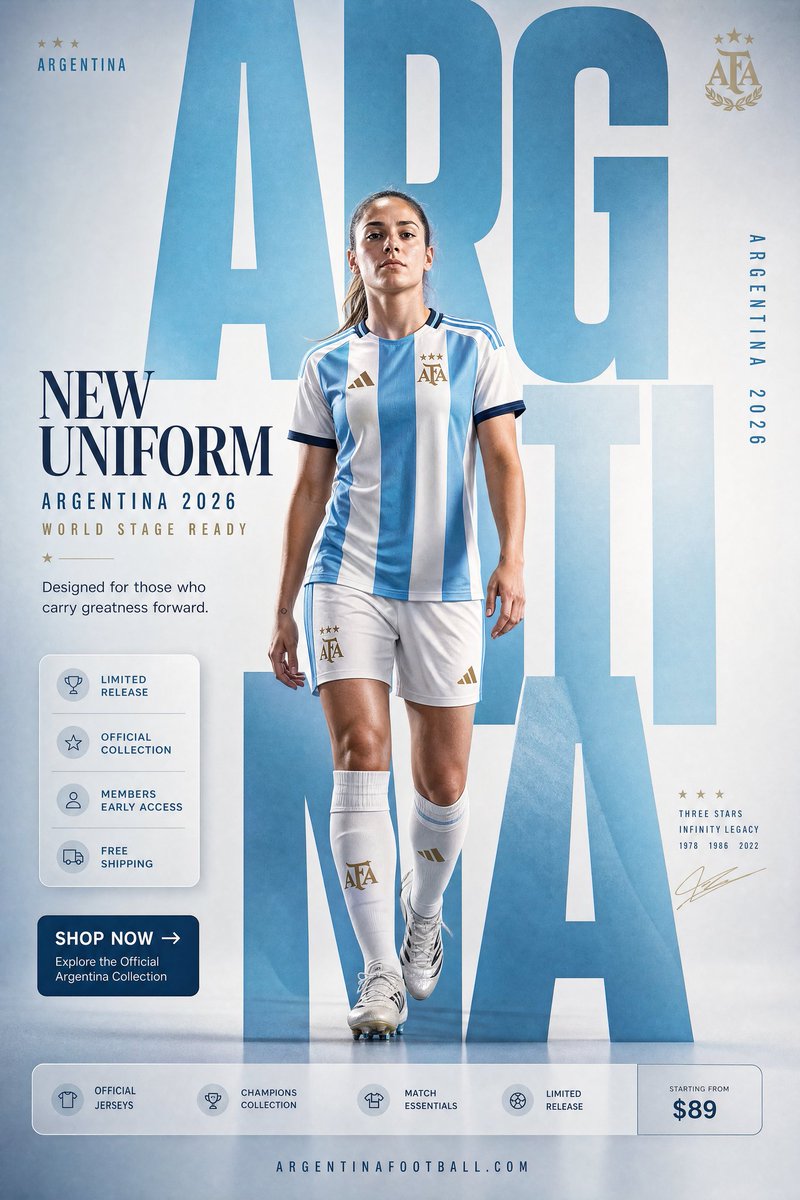
インフォグラフィック・スライド・QR code:GPT Image 2 のテキストワークフロー
約 99% の多言語テキスト精度が本物のドキュメントを可能にする——ただしモデルはデータを捏造するので、事実は自分で検索し prompt に注入すること。
テキストレンダリングはギミックからツールへと一線を越えた
画像モデルの第一世代を通じて、テキストこそが綻びだった。看板は擬似文字に溶け、チャートはノイズに崩れ、ドキュメントらしきものは端から論外だった。GPT Image 2 がそれを変えた——サードパーティの報道は、その文字レベルのテキスト精度を10以上の文字体系でおよそ99%としている。ラテン文字、日本語、韓国語、中国語、ヒンディー語、ベンガル語、アラビア語など、英語を埋め込んだ日本語や西洋数字と並走するアラビア語のような混在レイアウトも含めてだ。
この飛躍は独立した検証でも表れている。編集ベンチマークを回した Hacker News のコメント投稿者は、スコアが旧バージョンの 3/12 から新モデルの 10/12 に上がったと報告し、VentureBeat の発表見出しはこのカテゴリー転換をこう要約した——多言語テキスト、完全なインフォグラフィック、スライド、地図、さらにはマンガまで、ほぼ完璧に、と。
二つ目の要素はグリフそのものと同じくらい重要だ——モデルは密度の高いシーンの中で 100 以上の個別オブジェクトを一貫してレンダリングできる。この密度こそが、データの注釈、小さな UI ラベル、混み合った比較チャートを、テクスチャに崩れさせず判読可能に保つ。正確な文字に密なシーンの一貫性が加わる——この組み合わせが、アートのおもちゃをドキュメントのツールへと変える。
いま実際に出荷できるもの
1つ前のモデル世代では不可能だった一群の成果物が、いまや prompt 1本で手の届く距離にある:
- ラベル付きセクション、データ注釈、比較チャートを備えた完全な infographic
- 見出し、本文、チャートを1フレームに構成したプレゼンテーションスライド
- 使える・スキャンできる QR code やバーコードをデザインに直接埋め込んだポスターやパッケージ——Hacker News で出回った「ぶっ飛んだ用途」紹介記事で実証された
- ラベル付き地域の地図、台詞を入れたマルチパネルのマンガ、雑誌風レイアウト
- 製品モックアップ内の、近寄って読んでも崩れない小さな UI ラベル
多言語の側面は脚注ではない。TechCrunch が Sensor Tower と Similarweb のデータを引用して伝えるところでは、ヒンディー語とベンガル語のレンダリング改善がインドで地域的なミームとポスター制作の波を生んだ——報道によれば発表週のインドでの ChatGPT ダウンロードは約500万件、対して米国は約200万件で、今回の発表で計測可能な最大の普及ストーリーだった。
誰も警告してくれない失敗モード
ここに罠がある——モデルはいまやテキストを完璧にレンダリングするので、その出力は権威ありげに見える。そして、そのテキストの中身を自信満々に捏造するのだ。成績のインフォグラフィックを頼めば、もっともらしい数字をでっち上げる。広く共有された一例: 2026年4月のロンドンマラソンの成績インフォグラフィックは、きれいで読みやすく、プロ仕様のレイアウトでありながら、実際の世界記録をあっさり外していた。すべての文字は正しくレンダリングされていた——その背後の事実が間違っていたのだ。
テキストの正確さと事実の正確さは別の性質だ。GPT Image 2 は優れた組版者であり、お粗末なリサーチャーだ。あなたのインフォグラフィックが重要な場所に向かうなら——クライアント向けデック、レポート、あなたの名前が載るソーシャルアカウント——データをモデルに供給させてはならない。
コミュニティで実証されたパイプラインは率直だ: ウェブ検索は自分で回し、取得した事実を唯一の信頼できる情報源として prompt に貼り付け、モデルにはそれだけを使えと指示する。開発者はさらに一歩進めて、モデルの学習記憶のいかなるものも信用せず、プログラムでデータを注入して gpt-image-2 API を直接呼び出す。
本番ワークフロー、ステップごとに
- まずリサーチ: 数字、名前、日付は実在のソースから引く。決してモデルからではなく
- 事実は短いラベル付きの行(LABEL: value)に構造化する——モデルはそれをレイアウトのコンテンツとして扱う
- レイアウト言語を指定する: セクション、注釈、チャートの種類、言語、アスペクト比
- 生成したら、すべての数値をソースリストと照合して校正する——「正しそうに見えるか」ではなく
このワークフローを本物の仕事に任せて信頼する前の良いキャリブレーションテストは、サードパーティのテスターが多言語レンダリングを検証するのに使った prompt だ——すべてのテキストが読みやすく、正しく綴られて返ってきた:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.本物の成果物には、事実注入テンプレートに切り替える。DATA と END DATA の間のすべてはあなた自身のリサーチから来る。モデルの仕事は純粋に視覚だ。「追加・推定するな」という指示が荷重を担う——それがないと、モデルは「親切にも」捏造した文脈で空白を埋め、しかもそれが完全に説得力ありげに見えてしまう:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
prompt を本番インフラとして扱う
コミュニティはすでにそうしている。テキスト精度に依拠したタイポグラフィのポスターは、まとめられたコミュニティの prompt テンプレート上位10本の1つであり、wuyoscar/GPT-Image2-Skill テンプレートリポジトリは報道によれば発表から約6週間で 2,862 stars と 253 forks に達した——GitHub API で検証可能な数字だ。人々はこれらのテンプレートを、珍品を集めるようにではなく、コードをバージョン管理するようにバージョン管理している。
あなたのインフォグラフィックのワークフローでも同じことをしよう: LAYOUT と STYLE のブロックは固定し、ジョブごとに DATA ブロックだけを差し替える。そうすれば出力はシリーズ全体で視覚的に一貫したままになる。ポスターやテキスト主体のレイアウトの出来合いの出発点が欲しければ、https://gpt-img2.com/prompts の prompt ライブラリを覗いてみてほしい。
GPT Image 2 は無料で始められる——サインアップで20クレジット、クレジットカード不要だ。まず espresso のテスト prompt を回してテストレンダリングを自分の目で確かめ、それから自分でリサーチしたデータを持ち込んで、https://gpt-img2.com でフルワークフローを試してほしい。
Try these GPT Image 2 prompts