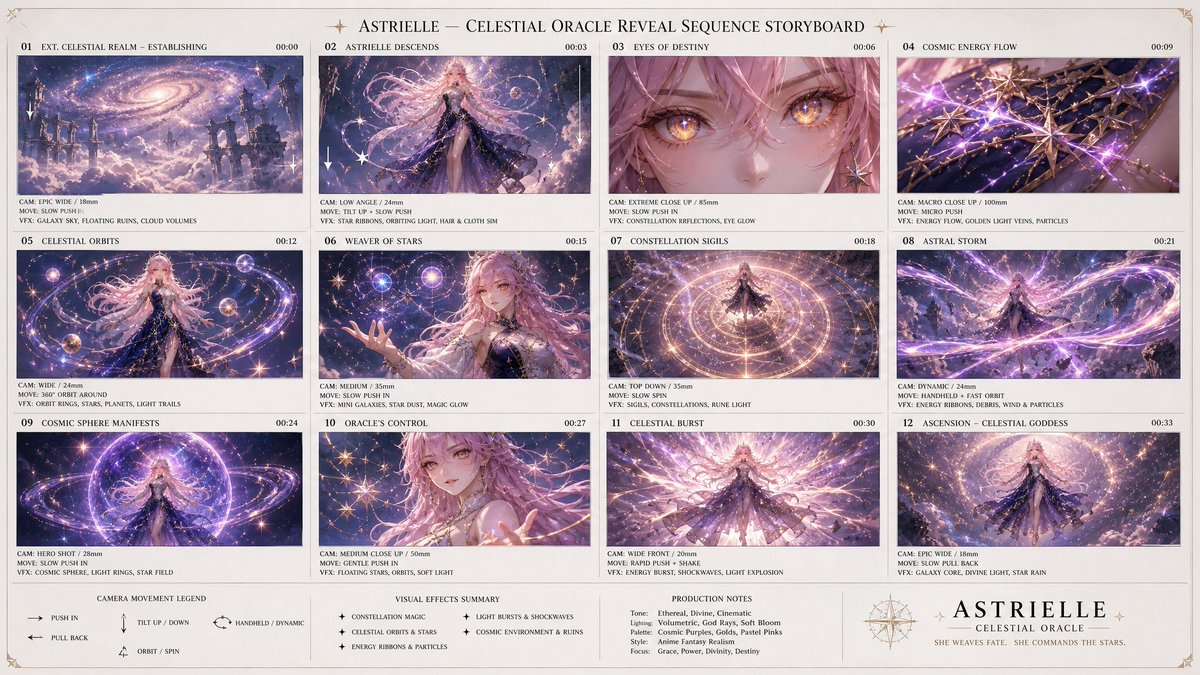
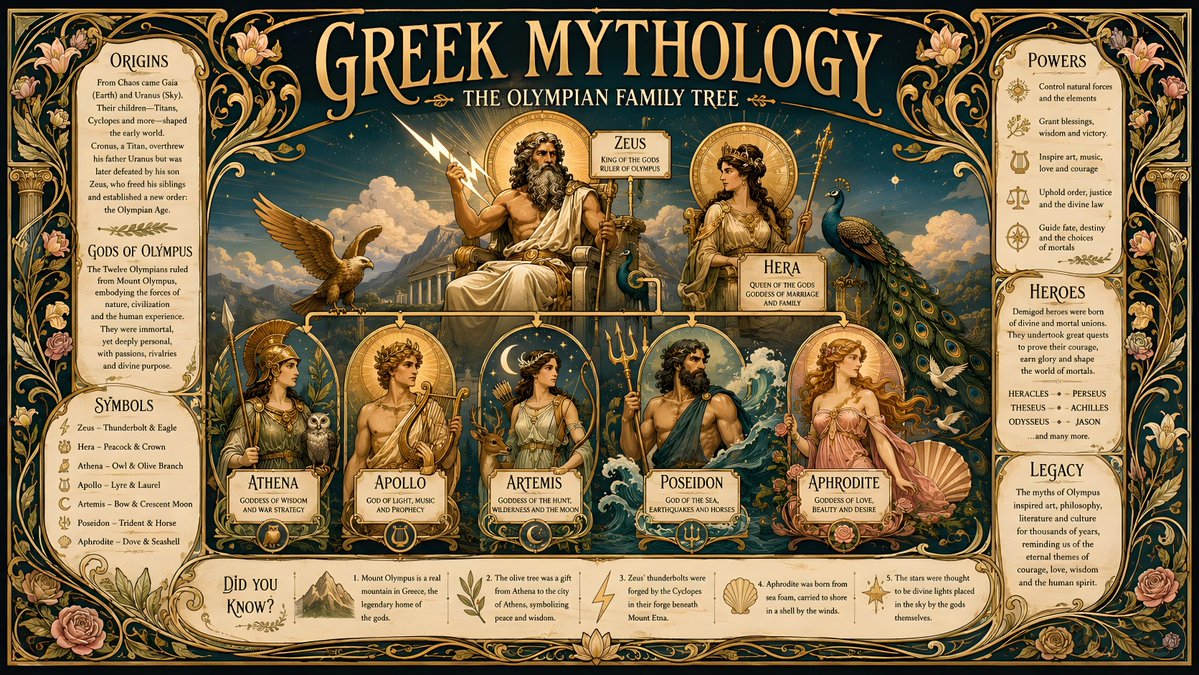
信息图、幻灯片与二维码:GPT Image 2 文字工作流
约 99% 的多语言文字准确率让真实文档成为可能——但模型会编造数据,所以请自己去搜索事实,再把它们注入 prompt。
文字渲染从噱头跨进了工具的门槛
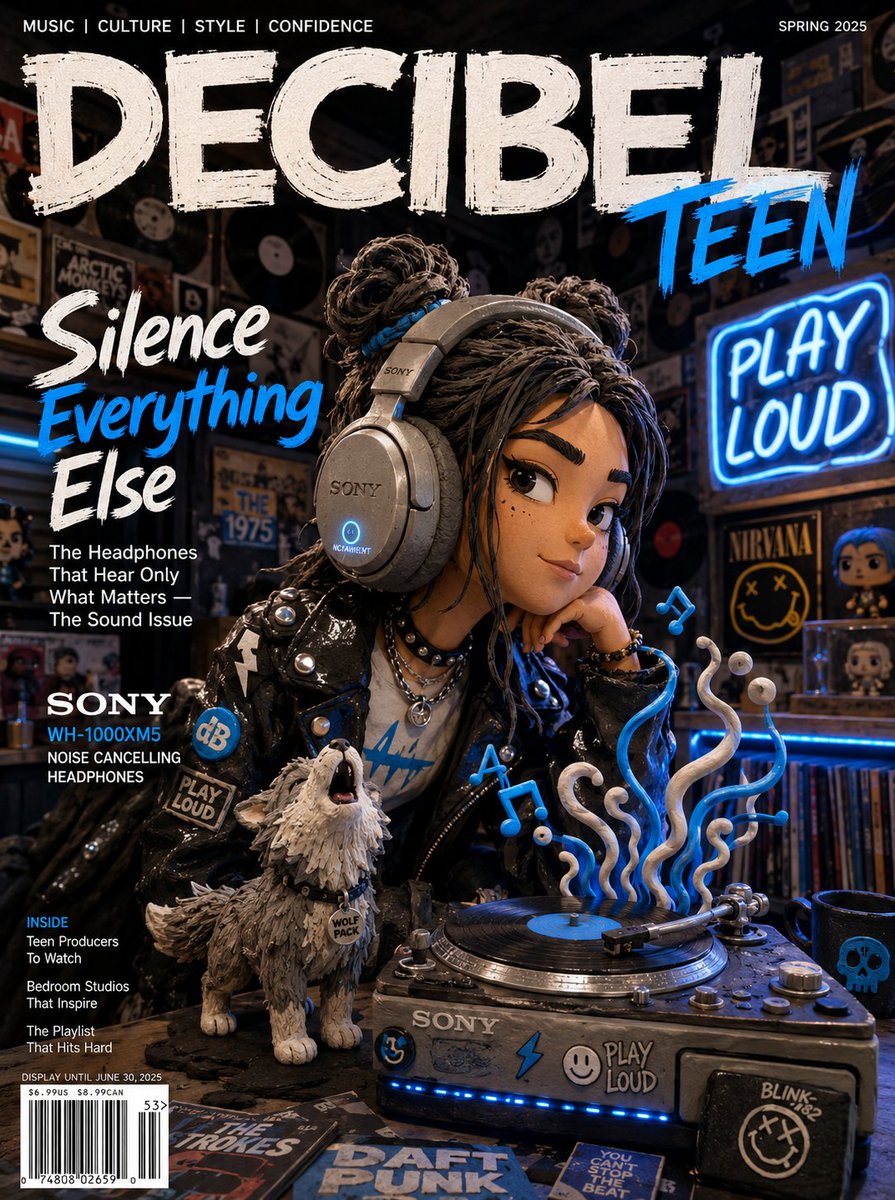
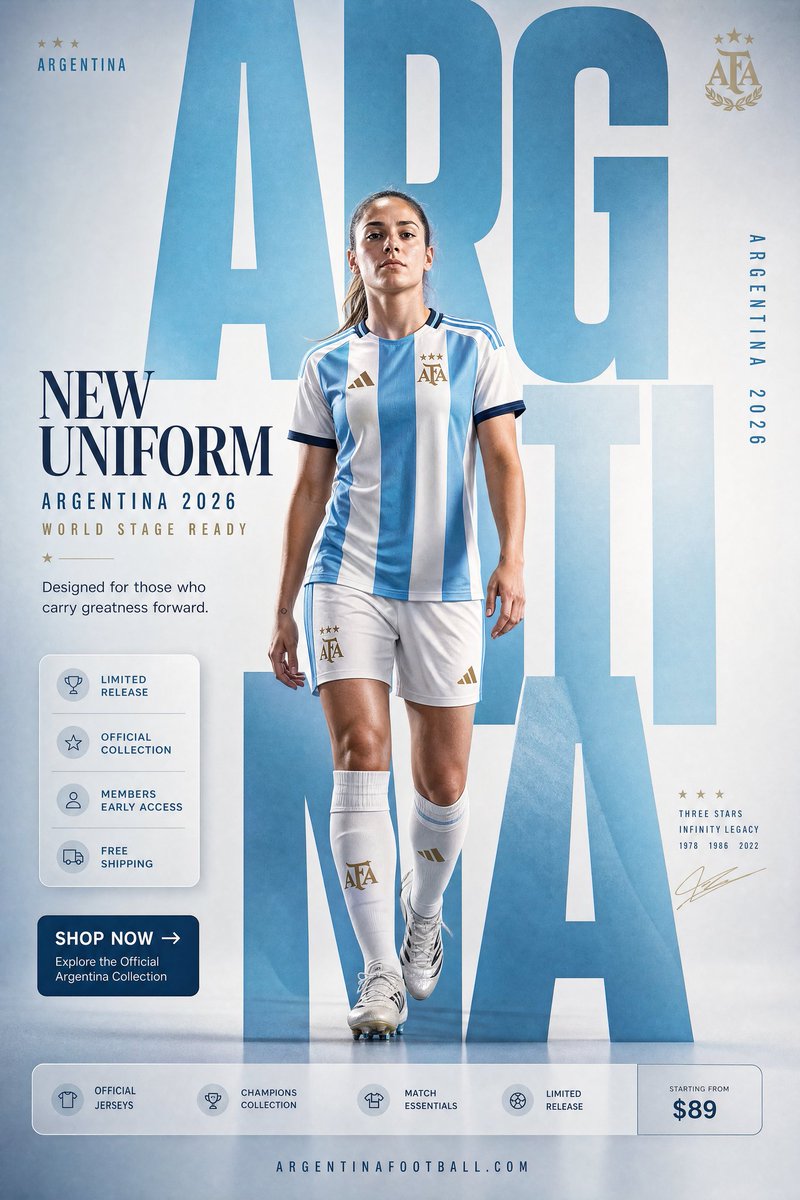
在图像模型的整个第一代里,文字就是破绽。招牌融化成伪字母,图表瓦解成噪点,任何像文档的东西都根本无从谈起。GPT Image 2 改变了这一点:第三方报道把它的字符级文字准确率定在十多种文字系统下约 99%——拉丁文、日文、韩文、中文、印地文、孟加拉文、阿拉伯文等等——包括混合文字系统的版式,比如嵌入英文的日文,或与西文数字并排的阿拉伯文。
这种跃升在独立测试里同样显现。Hacker News 上跑编辑基准的评论者报告说,分数从早期版本的 3/12 升到了新模型的 10/12,而 VentureBeat 的发布标题概括了这一品类层面的转变:多语言文字、完整信息图、幻灯片、地图,乃至漫画——看上去几乎毫无瑕疵。
第二个要素和字形本身一样关键:模型能在一个密集场景里连贯地渲染 100+ 个互不相同的对象。正是这种密度让数据标注、细小的 UI 标签和拥挤的对比图表保持清晰,而不是塌缩成纹理。准确的字符加上密集场景的连贯性,正是把一个艺术玩具变成文档工具的组合。
你现在真正能交付的东西
上一个模型世代还不可能做到的一整类交付物,如今只差一句 prompt:
- 带标注分区、数据注释和对比图表的完整 infographic
- 在一帧里组合好标题、正文与图表的演示幻灯片
- 把可用、可扫描的 QR code 和条形码直接嵌入设计的海报与包装——这在一篇曾在 Hacker News 上广为流传的「奇葩用例」文章里有过演示
- 带标注区域的地图、配字对白的多格漫画、杂志风版式
- 产品 mockup 里经得起细看的小号 UI 标签
多语言这一面绝非脚注。据 TechCrunch 引用 Sensor Tower 与 Similarweb 的数据,印地文与孟加拉文渲染的改进在印度掀起了一波区域性表情包与海报创作——据报道发布周期间在印度约有 500 万次 ChatGPT 下载,而美国约为 200 万次,是这次发布中可量化的最大采用故事。
没人提醒你的那种失败模式
陷阱在这里:模型现在能把文字渲染得完美无瑕,所以它的输出看起来很权威——而它会自信满满地编造那些文字的内容。让它做一张成绩信息图,它就会捏造出一组看似合理的数字。一个被广泛分享的例子:一张 2026 年 4 月伦敦马拉松成绩信息图,干净、清晰、排版专业,却干脆漏掉了实际的世界纪录。每一个字符都渲染正确;字符背后的事实却是错的。
文字准确和事实准确是两种不同的属性。GPT Image 2 是个出色的排版师,却是个糟糕的研究者。如果你的信息图要去往任何重要的地方——客户演示稿、报告、署着你名字的社交账号——你就不能让模型来提供数据。
社区验证过的流程很直白:自己去跑网络搜索,把检索到的事实作为唯一事实来源粘进 prompt,并告诉模型只用这些。开发者还更进一步,直接调用 gpt-image-2 API,以编程方式注入数据,而不是去信任模型训练记忆里的任何东西。
生产工作流,分步拆解
- 先研究:从真实来源拉取你的数字、名称和日期,绝不从模型那里取
- 把事实结构化成简短的带标签行(LABEL: value)——模型会把它们当作版式内容处理
- 指定版式语言:分区、标注、图表类型、语言、宽高比
- 生成后,逐一对照你的来源清单核校每个数字——而不是对照「看起来对不对」
在你信任这套工作流去做真正的工作之前,一个好的校准测试就是第三方测试者用来验证多语言渲染的那条 prompt——所有文字都返回得可读且拼写正确:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.对于真正的交付物,切换到一个事实注入模板。DATA 与 END DATA 之间的一切都来自你自己的研究;模型的工作纯粹是视觉。那条「不要添加或估算」的指令是承重的——没有它,模型会「热心地」用编造的上下文填补空白,而且看起来会非常令人信服:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
把 prompt 当作生产基础设施来对待
社区已经这么做了。倚赖文字准确度的排版海报,是被整理出来的十大社区 prompt 模板之一,而 wuyoscar/GPT-Image2-Skill 模板仓库据报道在发布约六周内达到了 2,862 stars 和 253 forks——这些数字可通过 GitHub API 核实。人们给这些模板做版本管理,就像给代码做版本管理一样,而不是当作猎奇藏品来收集。
对你的信息图工作流也照做:把 LAYOUT 与 STYLE 块固定下来,每个任务只替换 DATA 块,你的输出就能在一整个系列里保持视觉一致。如果你想要海报和文字密集版式的现成起点,可在 https://gpt-img2.com/prompts 浏览 prompt 库。
GPT Image 2 可免费开始——注册即得 20 个积分,无需信用卡。先跑那条 espresso 测试 prompt,亲眼看看文字渲染,然后带上你自己研究好的数据,到 https://gpt-img2.com 试一试完整工作流。
Try these GPT Image 2 prompts