Infografiken, Folien und QR codes: der Text-Workflow von GPT Image 2
~99% mehrsprachige Textgenauigkeit machen echte Dokumente möglich – aber das Modell erfindet Daten, also recherchiere die Fakten selbst und füge sie in den Prompt ein.
Die Textwiedergabe hat die Grenze vom Gimmick zum Werkzeug überschritten
Während der gesamten ersten Generation der Bildmodelle war der Text der Verräter. Schilder zerflossen zu Pseudobuchstaben, Diagramme lösten sich in Rauschen auf, und alles, was einem Dokument ähnelte, war schlicht ausgeschlossen. GPT Image 2 hat das geändert: Berichterstattung von Dritten beziffert seine zeichengenaue Textgenauigkeit auf rund 99% über mehr als zehn Schriftsysteme hinweg — Lateinisch, Japanisch, Koreanisch, Chinesisch, Hindi, Bengali, Arabisch und andere — einschließlich Layouts mit gemischten Schriften wie Japanisch mit eingebettetem Englisch oder Arabisch neben westlichen Ziffern.
Der Sprung zeigt sich auch in unabhängigen Tests. Hacker-News-Kommentatoren, die Bearbeitungs-Benchmarks laufen ließen, berichteten von Werten, die von 3/12 bei früheren Versionen auf 10/12 beim neuen Modell stiegen, und die Launch-Schlagzeile von VentureBeat fasste den Kategorienwechsel zusammen: mehrsprachiger Text, vollständige Infografiken, Folien, Karten, sogar Manga — scheinbar makellos.
Die zweite Zutat ist genauso wichtig wie die Glyphen: Das Modell kann über 100 verschiedene Objekte in einer dichten Szene kohärent rendern. Diese Dichte hält Daten-Callouts, kleine UI-Beschriftungen und überfüllte Vergleichsdiagramme lesbar, statt sie zu Textur zusammenfallen zu lassen. Genaue Zeichen plus Kohärenz dichter Szenen ist die Kombination, die aus einem Kunstspielzeug ein Dokumentenwerkzeug macht.
Was du jetzt wirklich ausliefern kannst
Eine ganze Kategorie von Liefergegenständen, die vor einer Modellgeneration noch unmöglich war, ist jetzt nur einen prompt entfernt:
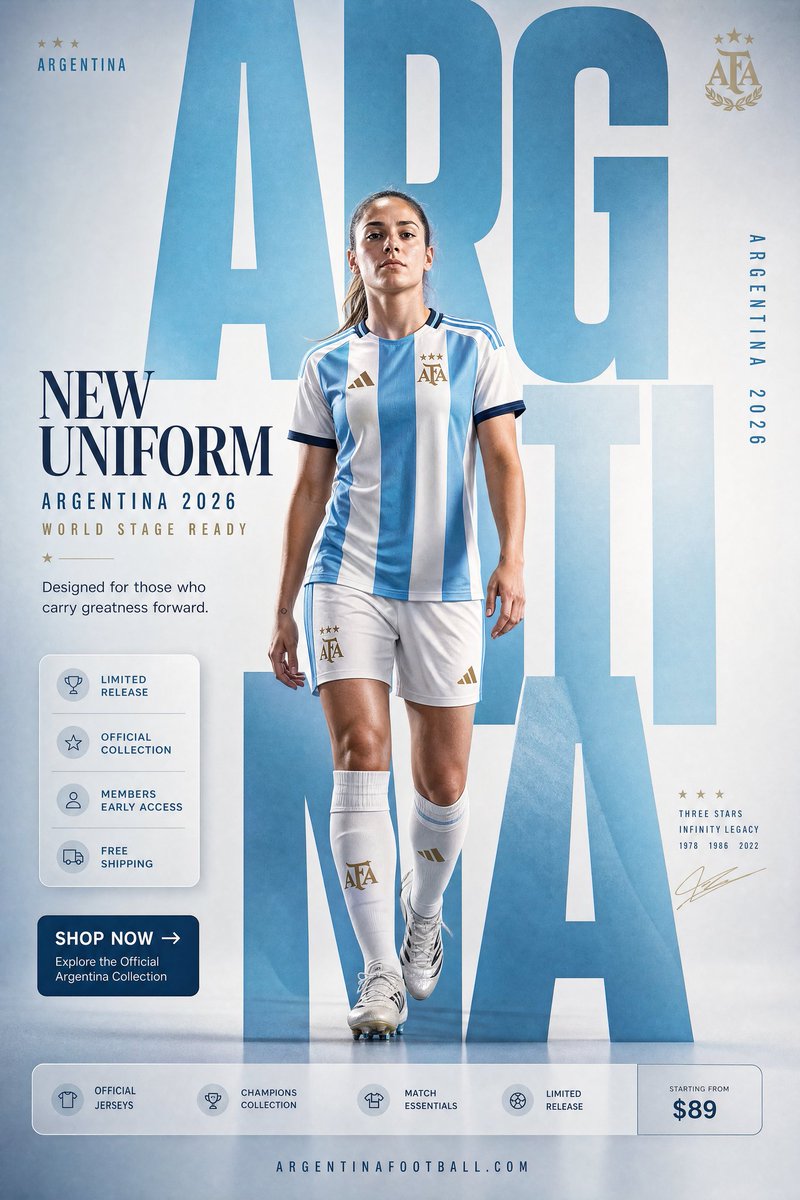
- Vollständige Infografiken mit beschrifteten Abschnitten, Datenannotationen und Vergleichsdiagrammen
- Präsentationsfolien mit Überschrift, Fließtext und einem Diagramm, in einem Frame komponiert
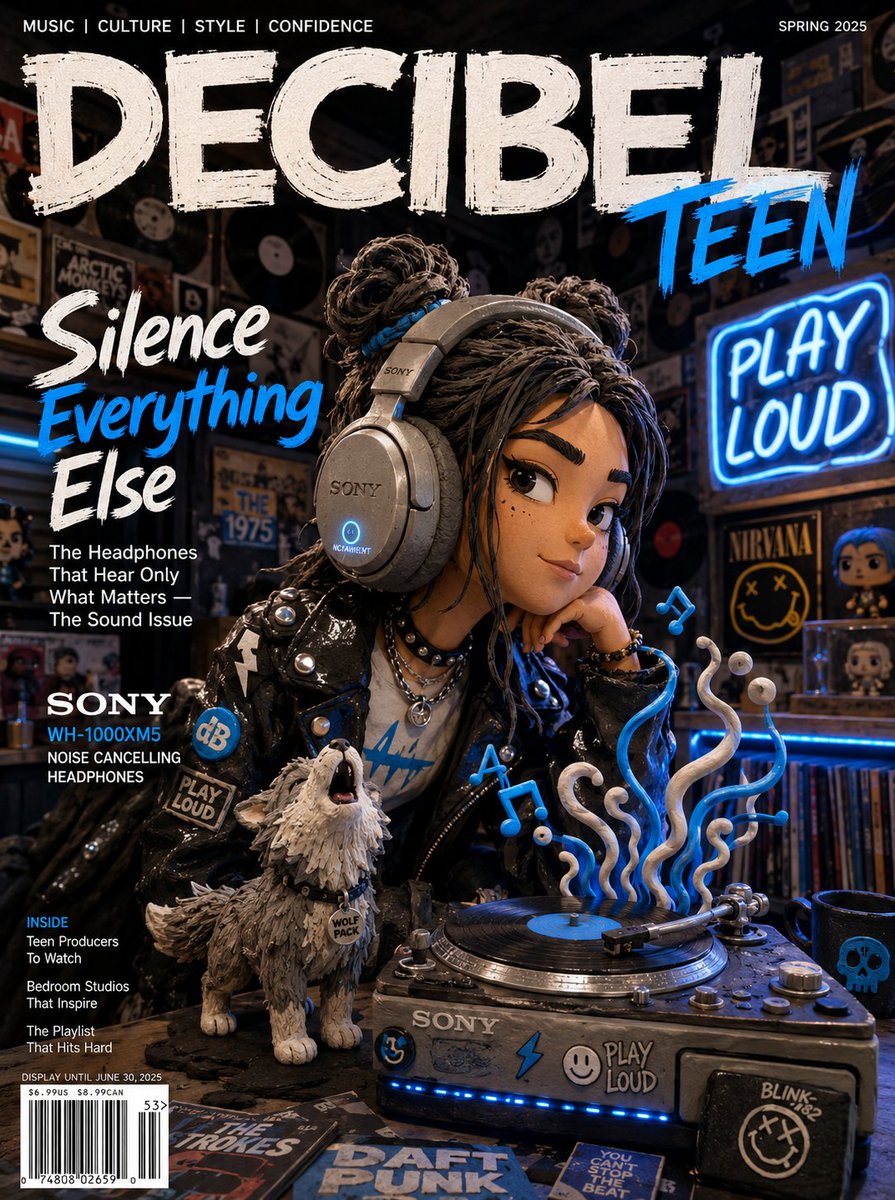
- Poster und Verpackungen mit funktionierenden, scanbaren QR codes und Barcodes, direkt ins Design eingebettet — demonstriert in einem Beitrag über verrückte Anwendungsfälle, der auf Hacker News die Runde machte
- Karten mit beschrifteten Regionen, mehrteiliger Manga mit gelettertem Dialog, Layouts im Magazinstil
- UI-Beschriftungen in kleiner Schrift in Produkt-Mockups, die genauem Lesen standhalten
Die mehrsprachige Seite ist keine Fußnote. Laut TechCrunch, unter Berufung auf Daten von Sensor Tower und Similarweb, befeuerte die verbesserte Hindi- und Bengali-Wiedergabe eine Welle regionaler Meme- und Postererstellung in Indien — Berichten zufolge rund 5 Millionen ChatGPT-Downloads dort während der Launch-Woche gegenüber rund 2 Millionen in den USA, die größte messbare Adoptionsgeschichte des Launches.
Der Fehlermodus, vor dem dich niemand warnt
Hier ist die Falle: Das Modell rendert Text jetzt perfekt, sodass seine Ausgabe maßgeblich aussieht — und es wird den Inhalt dieses Textes selbstbewusst erfinden. Bitte um eine Ergebnis-Infografik, und es erfindet plausible Zahlen. Ein vielfach geteiltes Beispiel: eine Ergebnis-Infografik zum London-Marathon vom April 2026, die sauber, lesbar und professionell gesetzt war und einfach den tatsächlichen Weltrekord verfehlte. Jedes Zeichen war korrekt gerendert; die Fakten dahinter waren falsch.
Textgenauigkeit und faktische Genauigkeit sind unterschiedliche Eigenschaften. GPT Image 2 ist ein hervorragender Setzer und ein schlechter Rechercheur. Wenn deine Infografik irgendwohin geht, wo es zählt — ein Kunden-Deck, ein Bericht, ein Social-Account mit deinem Namen darauf — darfst du das Modell die Daten nicht liefern lassen.
Die von der Community erprobte Pipeline ist unverblümt: Führe die Websuche selbst durch, füge die gefundenen Fakten als einzige Wahrheitsquelle in den prompt ein und sag dem Modell, nur diese zu verwenden. Entwickler gehen noch einen Schritt weiter und rufen die gpt-image-2-API direkt mit programmgesteuert eingespeisten Daten auf, statt irgendetwas im Trainingsgedächtnis des Modells zu vertrauen.
Der Produktions-Workflow, Schritt für Schritt
- Recherchiere zuerst: Hol deine Zahlen, Namen und Daten aus echten Quellen, niemals aus dem Modell
- Strukturiere die Fakten als kurze beschriftete Zeilen (LABEL: value) — das Modell behandelt sie als Layout-Inhalt
- Gib die Layoutsprache an: Abschnitte, Callouts, Diagrammtyp, Sprachen, Seitenverhältnis
- Generiere, dann lies jede Zahl gegen deine Quellenliste Korrektur — nicht gegen das, was richtig aussieht
Ein guter Kalibrierungstest, bevor du dem Workflow echte Arbeit anvertraust, ist der prompt, den Drittanbieter-Tester zur Verifizierung der mehrsprachigen Wiedergabe verwendeten — der gesamte Text kam lesbar und korrekt geschrieben zurück:
Create a step-by-step infographic explaining how espresso is made, with labeled sections, data callouts and a comparison chart, in Japanese with English subtitles.Für echte Liefergegenstände wechsle zu einer Fakteneinspeisungs-Vorlage. Alles zwischen DATA und END DATA stammt aus deiner eigenen Recherche; die Aufgabe des Modells ist rein visuell. Die Anweisung, nichts hinzuzufügen oder zu schätzen, ist tragend — ohne sie füllt das Modell hilfsbereit die Lücken mit erfundenem Kontext, und es wird völlig überzeugend aussehen:
Create a clean one-page results infographic.
Use ONLY the facts below — do not add, estimate or "correct" any number.

DATA:
EVENT: [event name and date]
WINNER: [name] — [time or score]
RECORD: [current record holder and mark]
KEY STAT 1: [label]: [value]
KEY STAT 2: [label]: [value]
END DATA

LAYOUT: bold headline at top, three labeled stat callouts,
one simple comparison bar chart, footer with a source line.
STYLE: flat editorial infographic, two-color palette, generous spacing.
Behandle prompts wie Produktionsinfrastruktur
Die Community tut das bereits. Typografie-Poster, die sich auf die Textgenauigkeit stützen, gehören zu den konsolidierten Top-Ten-prompt-Vorlagen der Community, und das Vorlagen-Repo wuyoscar/GPT-Image2-Skill erreichte Berichten zufolge innerhalb von etwa sechs Wochen nach dem Launch 2.862 Stars und 253 Forks — über die GitHub-API verifizierbare Zahlen. Die Leute versionieren diese Vorlagen so, wie sie Code versionieren, nicht so, wie sie Kuriositäten sammeln.
Mach dasselbe mit deinem Infografik-Workflow: Halte die LAYOUT- und STYLE-Blöcke fest, tausche den DATA-Block pro Auftrag, und deine Ausgabe bleibt über eine ganze Serie hinweg visuell konsistent. Wenn du fertige Ausgangspunkte für Poster und textlastige Layouts willst, durchstöbere die prompt-Bibliothek unter https://gpt-img2.com/prompts.
GPT Image 2 ist kostenlos zum Starten — du bekommst 20 Credits bei der Anmeldung, keine Kreditkarte nötig. Lass zuerst den Espresso-Test-prompt laufen, um die Textwiedergabe selbst zu sehen, und bring dann deine eigenen recherchierten Daten mit und probiere den vollständigen Workflow unter https://gpt-img2.com aus.
Try these GPT Image 2 prompts
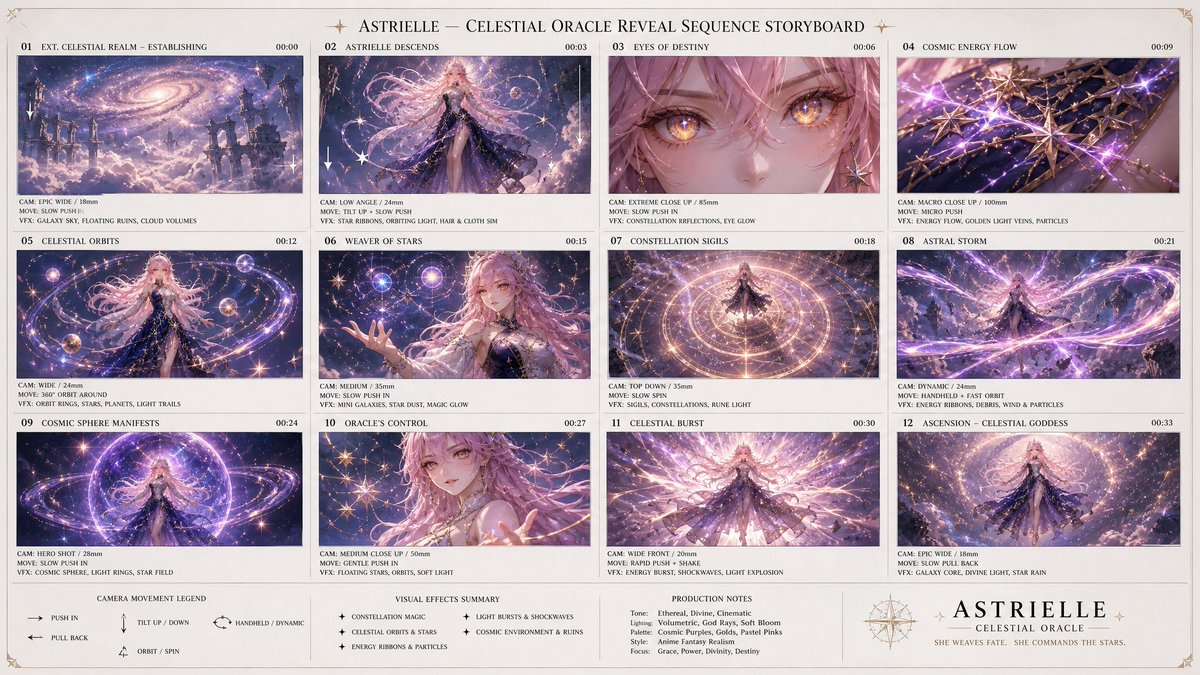
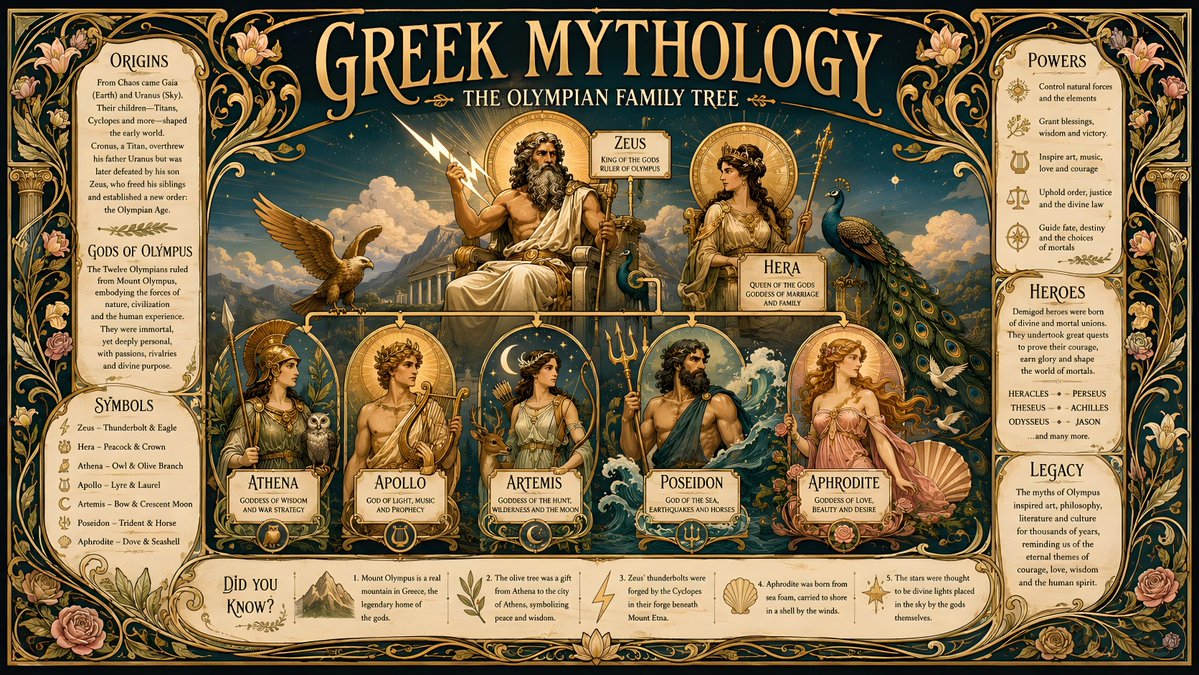
Probiere diese Techniken jetzt aus
Öffne den kostenlosen GPT-Image-2-Generator und setze es um — 20 Gratis-Credits, ohne Kreditkarte.