GPT Image 2 的侷限:它做不到什麼(以及如何繞過)
GPT Image 2 確實強,但它不是魔法。這裡是真正會絆倒人的那些約束——以及每一條的解法。
為什麼一份誠實的侷限清單值得一讀
大多數「GPT Image 2」文章讀起來像宣傳冊。這篇不是。如果你曾經輸入一段 prompt、拿回一張幾乎對了的圖,然後懷疑是不是自己用錯了工具,答案通常是「沒用錯」——你撞上的是模型、API 或它周邊產品管線的一條真實約束。
好消息是,這些侷限大多有切實可行的緩解辦法,而且一旦你知道邊界在哪,大多都很簡單。GPT Image 2 在 prompt 服從度、圖內文字和照片級細節上依舊很強。知道邊界在哪,只是讓你不再跟它硬扛,而是繞道而行。
下面的一切都基於模型和 gpt-img2.com 管線今天的真實行為。凡是屬於硬性產品限制(解析度、透明度、內容政策),我們都直說,而不是假裝某個 prompt 技巧能克服它。
侷限 1 —— 沒有透明背景
在 gpt-img2.com 上你拿不回透明 PNG。如果你要求透明或帶 alpha 通道的背景,管線會悄悄把它降級成普通背景——你不會看到報錯,只會拿到一張不透明的圖。這會坑到那些想要乾淨 logo、貼紙、產品去背或 UI 素材好疊到另一層上的人。
原因:生成返回的是一張已完成、已壓平的點陣圖,而不是帶 alpha 通道的分層檔——所以在這條管線裡,並沒有一個能替你把主體去背出來的透明背景模式。把透明當作一道後期工序,而不是生成器直接交給你的東西。
解法:在一個與主體強烈反差的純單色平背景上生成,然後把去背作為獨立的後期步驟來做。一個純淨的色鍵色(亮綠或洋紅)在幾乎任何去背工具裡都能乾淨地去出來。只是要為棘手的邊緣多留點時間——細髮絲、玻璃、運動模糊和柔和陰影是自動去背最吃力的地方,所以你要奔著一個硬朗、乾淨的剪影去設計。
A single product, a white ceramic coffee mug, centered on a flat solid bright-green (#00FF00) background, even studio lighting, no shadows on the background, sharp edges, no props. Product-shot style.「平背景」和「no shadows on the background」這條指令是關鍵——它們給你的去背工具一條乾淨、毫不含糊的邊來切。對於 logo 和圖示,同樣在純色背景上放大生成、再用同樣方式去出來;別指望模型本身會交給你一個透明檔。
侷限 2 —— 4K 僅限寬和高的長寬比
在 gpt-img2.com 上你可以按 1K、2K 或 4K 生成。但 4K 不是每種形狀都支援。它只支援六種長寬比:16:9、9:16、2:1、1:2、21:9 和 9:21——全都是寬幅或高幅的全景比例。正方形(1:1)、4:3、3:2、4:5 或其他任何標準比例,最高只能到 2K 檔。
原因:在 gpt-img2.com 管線裡,4K 預設只對那六種寬和高的比例開放。正方形及接近正方形的比例封頂在 2K 檔,而不會讓你為一個預設根本產不出的尺寸去付 4K 的價。
這意味著這裡沒有 4K 正方形。如果你需要一張非常大的 1:1——比如一張 4000×4000 的列印件或一枚高 DPI 的應用圖示——單靠生成器一次是出不來的。
解法:按輸出比例來挑該打哪場仗。如果你確實需要 4K 細節,就把你的畫面構圖成那六種受支援的寬/高比例之一(16:9 和 9:16 已經覆蓋了大多數螢幕、海報和社群需求)。如果你非要一張大正方形,就在 2K 生成,再用專門的影像放大工具把結果放大——把一張乾淨的 GPT Image 2 出圖從 2048 放大到 4096 在不少情況下效果不錯,具體取決於來源細節和最終列印尺寸。在寫 prompt 之前就規劃好比例,而不是寫完之後。
侷限 3 —— 圖內文字很強,但不是像素級精準
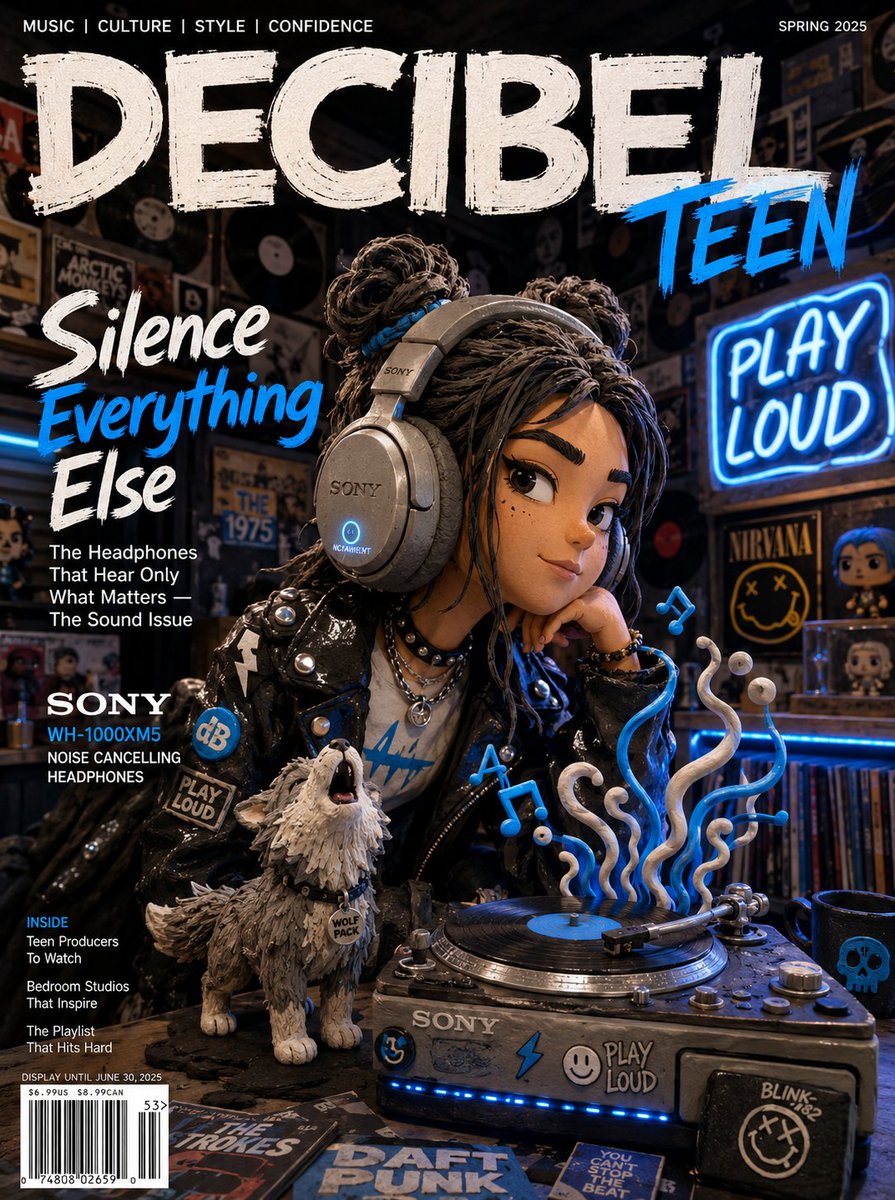
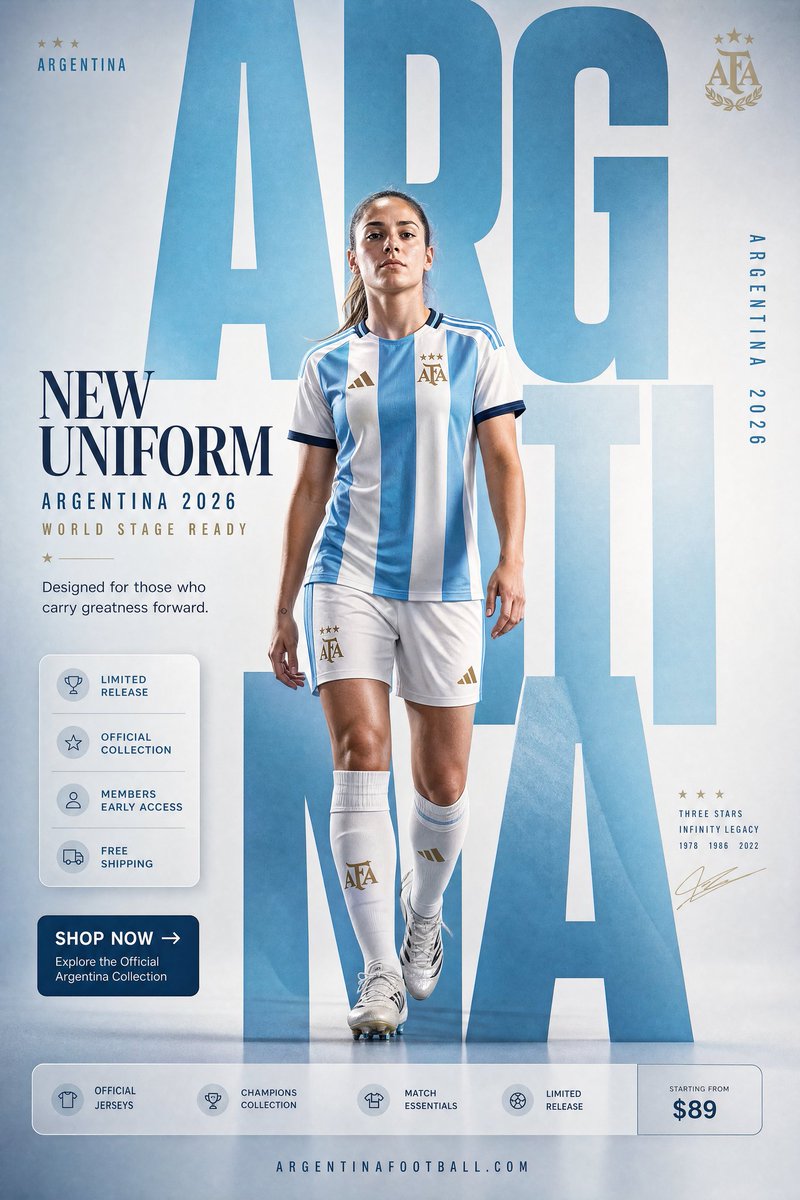
GPT Image 2 渲染可讀文字的能力遠勝舊式擴散模型——短標籤、標題、招牌和 UI 草稿通常出來都乾淨、拼寫正確。但它不是一台排版引擎。長單字、密集段落、不尋常的品牌名和小號正文,仍然可能出現漏字、字元重複或細微的拼寫錯誤。
原因:模型是在你的 prompt 引導下,把文字當作「看起來像字母的形狀」來畫,而不是去排一套字體。字串越長、越不尋常,某個字形走樣的機會就越多——而一個字母錯了就毀掉整個單字。
解法:讓模型要渲染的文字保持簡短,把又長又關鍵的文案作為獨立的一步加上去。
- 在 prompt 裡引用確切文字:把要出現的字詞寫成 "GRAND OPENING" 一字不差,而不是只說 "a sign that says grand opening"——加引號能減少模型自由發揮
- 寧要幾個短詞,不要句子;要的是標題,不是段落
- 凡是有法律或商業分量的內容(價格、品牌名、聯絡方式),先生成不帶這些文字的畫面,事後在任意設計工具裡疊上真實文字——這樣能保證零錯字
- 如果某個單字回來時拼錯了,把這張圖作為參考餵回去,要求只修這一個詞的編輯,而不是把整個場景重搖一遍
把 GPT Image 2 當成一位才華橫溢、但拼寫稍微有點不靠譜的插畫師:讓它畫圖,而真正重要的字眼留在你自己的掌控裡。
侷限 4 —— 角色一致性能被幫一把,但不被保證
每一次生成都是一次獨立取樣。除非你把先前的圖作為參考傳回去,否則模型對它上一張畫的圖毫無記憶,所以在你主動釘死身分之前,「同一個」角色會在不同執行間漂移。參考圖能帶來巨大差別,而且你可以傳不止一張(API 支援多張;網頁 UI 暴露的數量可能更少)——但即便有參考圖,逐格完全一致的完美匹配也不被保證。臉和細節可能在多次生成間輕微變動。
原因:參考圖會強烈地把輸出偏向某個相似度,但模型每次仍然是從零重新合成整張圖。它保留的是身分的「大意」,而不是一張臉的精確像素拷貝。
解法:把那些能降低歧義的技巧疊起來用。
- 始終傳同一張參考圖,並把 prompt 寫成一次變換:"using the provided image, keep the face, hair, and outfit identical; change only the background"
- 加一段文字身分錨點——一個固定的、超級具體的特徵塊(確切的頭髮、一個辨識度強的特徵、一套招牌穿搭)——並逐字貼進每一個 prompt
- 對接近成功的圖做迭代,而不是重搖:當一張圖對了 90% 時,把它餵回去,一次只改一個變數,這樣每一輪都保留住已經奏效的部分
我們在角色一致性指南裡有這些方法的完整演練;一句話版本是:一致性是靠消除歧義工程化出來的,不是用一個關鍵詞求來的。
侷限 5 —— 內容政策會拒絕某些 prompt
有些 prompt 不會生成。對露骨或 NSFW 內容的請求,以及某些涉及真實公眾人物或可辨識的受版權和商標保護角色的 prompt,可能被安全系統拒絕——發生這種情況時,任務會以內容政策錯誤失敗,而不是返回一張圖。這是一條硬性限制,不是 prompt 工程能解決的問題:沒有任何合法表述能繞過它,嘗試繞過也違反規則。
原因:生成執行在一層內容審核之後。並非每一個公眾人物或角色 prompt 都會被攔,但當某個 prompt 確實觸發了政策時,它會失敗而不是返回一張圖,而這個判定不由你掌控。
合規替代方案:圍著政策來設計,而不是跟它硬扛。
- 想要某位公眾人物的味道?描述一個你真正想要的屬性集(年齡、風格、情緒、場景)的原創人物,而不是點名某位真實名人
- 想要一個吉祥物或主角?創造一個原創角色——這是個低風險的起點,因為受版權和商標保護的角色無論由誰生成都帶著法律風險
- 在某個感覺無害的東西上吃了拒絕?觸發點往往是某個有歧義的單字;用中性、具體的措辭重述場景,通常就能通過
如果你打算把圖用於商業用途,這條侷限悄悄地其實是個特性:政策攔下的那些 prompt,和日後會帶來商標、肖像或版權風險的那些高度重疊。(關於使用權的完整圖景,見我們的商業使用指南。)
侷限 6 —— 高品質生成需要時間
在與輕量、單一用途生成器的正面較量中,GPT Image 2 不是最快的模型。一張簡單的單主體圖回來會比一個精簡的速度型模型稍慢,而最重的品質+解析度組合(想想 4K)可能要 130 秒甚至更久才能完成——複雜 prompt 確實要花上幾分鐘。
原因:模型為每張圖做了更多工作——更強的 prompt 服從度、更好的文字、更高的保真度——而這些算力會以延遲的形式體現出來,在最高解析度檔尤其明顯。
解法:讓檔位匹配任務,並批次處理。
- 在 1K 起草和探索。它又快又便宜,所以在那裡把構圖和 prompt 措辭迭代到位,直到圖對了為止
- 只在最終、已確認的構圖上才用 2K 或 4K 渲染——別在你將要扔掉的草稿上付出高解析度的時間(或點數)成本
- 在一次請求裡生成最多四張變體(每次請求的上限),而不是發四個獨立任務;一個任務就能給你好幾個選項
- 如果你為一張用完即棄的縮圖壓倒一切地需要速度,一個更輕的模型確實是更好的工具——GPT Image 2 的延遲,是花在那些必須出對的畫面上的
侷限 7 —— 非常長、多子句的 prompt 會被部分忽略
prompt 服從度是 GPT Image 2 的真本事之一——它遵循指令比大多數模型都好。但有個天花板。當你把一打要求塞進一條巨長的 prompt(每一個物體、顏色、位置、光照條件和風格備註全擠在一起)時,模型有時會悄悄丟掉或模糊掉其中某個要求。你疊的子句越多,越可能有一個被弄丟。
原因:單次生成必須同時滿足你所有的約束,當它們爭搶同一批像素時,模型會優先照顧主導元素、弱化其餘。相互矛盾的指令(「極簡」又「高度精細且華麗」)會讓情況更糟。
解法:把 prompt 結構化,減少競爭。
- 把最重要的那一件事——主體和構圖——放在最前面,然後按優先級遞減依次加修飾,這樣萬一有東西被丟掉,丟的也是最不重要的細節
- 去掉矛盾;選定一個風格方向,而不是在兩者之間騎牆
- 對於有幾個精確要求的場景,先生成基礎圖,再用迭代編輯一次一個地添加或修正單個元素,而不是要求一次過滿足所有
- 如果某個具體細節老是被忽略,給它一個獨立的短句,而不是把它埋在一條又長又流水的 prompt 中段子句裡
誠實的總結
這些侷限沒有一條讓 GPT Image 2 變成一個弱工具。它們是一個模型可預見的邊界——而這個模型總體而言在 prompt 服從度、圖內文字和照片級細節上都很出色。陷阱在於指望它同時還是個分層檔匯出器、一台排版引擎、一台「什麼都能 4K」的機器,以及一個確定性的角色克隆機——它一樣都不是,也沒有任何 prompt 能把它變成這些。
換個思路,順著邊界來工作:在平背景上渲染再去出透明,需要 4K 時為那六種寬和高的比例構圖,讓關鍵文字保持簡短、其餘的疊加上去,用參考圖和錨點釘死身分,圍著內容政策來設計,在 1K 起草、在高解析度定稿,並給你的 prompt 排好優先級,讓重要的東西不被搶去注意力。
最快搞清邊界在哪的方式,就是自己跑幾個 prompt。你可以在 gpt-img2.com 上免費試用 GPT Image 2——從 1K 開始探索,你就會切身感受到這些侷限裡,哪些對你的工作真要緊、哪些你壓根不會注意到。
Try these GPT Image 2 prompts